Озвучить сценарий для ролика, превратить PDF в аудио или встроить синтез речи в приложение — это три разные задачи, хотя во всех случаях используется TTS, то есть преобразование текста в речь. Для видео важны естественная интонация, контроль пауз и право публиковать полученный файл. Для чтения документов важнее загрузка PDF и EPUB, синхронизация между устройствами и удобный плеер. Для автоматизации нужны API, стабильные форматы вывода и предсказуемая тарификация.
В рейтинге собраны восемь инструментов, которые заметно различаются по рабочему процессу: видеоредактор со встроенной ИИ-озвучкой, настольная программа Windows, сервисы для личного чтения, браузерные студии и облачная платформа для разработчиков. В поле «Русский язык» ниже имеется в виду возможность синтезировать русскую речь; это не означает, что интерфейс каждого сервиса полностью переведен на русский.
- Краткое сравнение программ для озвучки текста
- Рейтинг программ и сервисов
- 1. ВидеоМОНТАЖ — озвучка сразу внутри видеопроекта
- 2. NaturalReader — чтение PDF, EPUB и документов с разделением личного и коммерческого использования
- 3. Звукограм — русскоязычный онлайн-синтез с оплатой за фактический объем
- 4. Murf AI — браузерная студия для озвучки с проектами и медиаматериалами
- 5. ElevenLabs — выразительная нейросетевая речь, Studio и клонирование голоса
- 6. Speechify — чтение документов на разных устройствах
- 7. Yandex SpeechKit — облачный синтез для приложений, ботов и автоматизации
- 8. Balabolka — локальная Windows-оболочка над установленными голосами
- Как выбрать TTS под конкретную задачу
- Проверка синтезатора за 15 минут
- Как подготовить текст, чтобы синтез речи звучал естественнее
- Разбивайте длинные предложения
- Числа и сокращения записывайте так, как их нужно услышать
- Паузы задавайте смыслом, а не количеством знаков
- Не усиливайте эмоцию на каждом предложении
- Чек-лист перед экспортом озвучки
- Типичные проблемы и способы диагностики
- Как встроить TTS в рабочий процесс видеомонтажа
- Что важнее количества голосов
- FAQ
- Можно ли использовать бесплатную TTS-озвучку в коммерческом видео?
- Что лучше для монтажа: MP3 или WAV?
- Нужен ли отдельный TTS-сервис, если видеоредактор уже умеет озвучивать текст?
- Можно ли озвучивать документы без загрузки их в облако?
- Вывод
- Предложить модель для рейтинга
Краткое сравнение программ для озвучки текста
| Инструмент | Тип | Где работает | Русская речь | Бесплатный старт | Основной сценарий |
|---|---|---|---|---|---|
| ВидеоМОНТАЖ | Видеоредактор с ИИ-озвучкой | Windows | Да | Демо 5 дней | Закадровый голос сразу на таймлайне |
| NaturalReader | Читалка и TTS-сервис | Веб, мобильные приложения, Chrome | Да | Есть Free | PDF, книги, учебные и рабочие документы |
| Звукограм | Онлайн-синтезатор | Браузер | Да | 1000 символов без регистрации | Русскоязычная озвучка, диалоги, длинные тексты |
| Murf AI | Браузерная студия | Веб | Да | 10 минут генерации, без скачивания | Озвучка презентаций, видео и обучающих материалов |
| ElevenLabs | ИИ-платформа речи | Веб, мобильные приложения, API | Да | 10 000 кредитов в месяц | Выразительная речь, Studio, клонирование голоса |
| Speechify | Читалка с TTS | Веб, Windows, macOS, iOS, Android, расширения | Да | Есть Free | Прослушивание документов и веб-страниц на разных устройствах |
| Yandex SpeechKit | Облачный TTS и API | Yandex Cloud, Playground, API | Да | Тарификация зависит от региона и API | Боты, приложения, массовая и автоматизированная генерация |
| Balabolka | Настольный TTS-клиент | Windows | Через установленный голос | Бесплатно для некоммерческого использования | Локальное чтение и сохранение больших документов |
Главное различие видно уже по таблице. ВидеоМОНТАЖ решает задачу в контексте монтажа, NaturalReader и Speechify — в контексте чтения, Murf AI и ElevenLabs — в контексте производства озвучки, Yandex SpeechKit — в контексте интеграции, а Balabolka работает как оболочка над установленными в Windows речевыми движками. Поэтому сравнивать их только по количеству голосов неправильно: важнее путь от текста до готового файла и условия его дальнейшего использования.
Рейтинг программ и сервисов
1. ВидеоМОНТАЖ — озвучка сразу внутри видеопроекта
ВидеоМОНТАЖ отличается от обычных TTS-сервисов тем, что синтез речи встроен в настольный редактор. Сценарий не нужно сначала превращать в аудиофайл на одном сайте, затем скачивать его и вручную переносить в другую программу. В редакторе можно собрать ролик, вызвать ИИ-озвучку, задать голос, настроение и темп, сгенерировать фрагмент и сразу добавить его в проект. Это особенно полезно для инструкций, обзоров, учебных роликов и коротких видео, где текст регулярно меняется вместе с монтажом.
Платформа: Windows 11, 10, 8 и 7.
Русский язык: есть.
Стоимость: программа платная, доступна демоверсия на 5 дней; на странице покупки представлены годовая и бессрочная лицензии. Промо-цены, срок действия которых уже закончился, в расчет не берем.
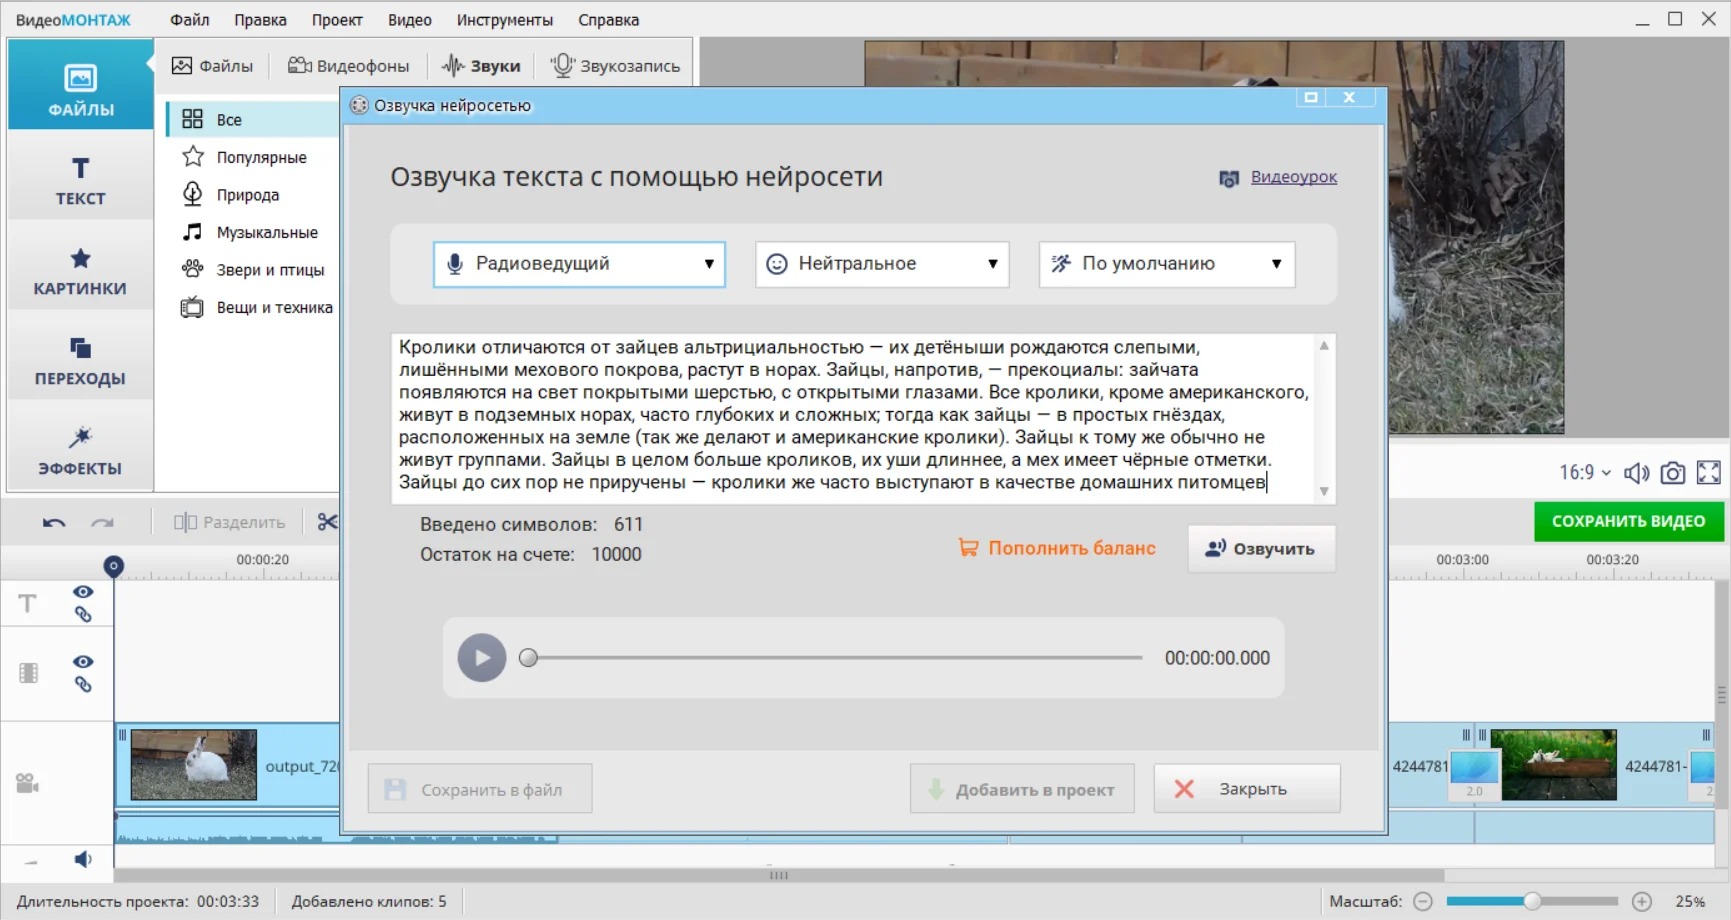
Для ИИ-озвучки используется команда «Озвучка с помощью нейросети». В окне задаются голос, настроение, темп и текст, после чего достаточно нажать «Озвучить» и «Добавить в проект». Такой порядок удобен, когда длительность реплики должна совпасть с конкретным планом: можно изменить текст, перегенерировать фразу и сразу увидеть, как она ложится на монтаж.
Сильная сторона решения — не сам факт наличия синтеза, а связка с видеорядом. После генерации не приходится отдельно собирать сцену в стороннем NLE. При этом у специализированных голосовых платформ выбор моделей, языков и тонких параметров обычно шире, поэтому для сложной многоголосой постановки или фирменного голосового профиля логичнее подготовить звук отдельно и импортировать его в видеоредактор.
Кому подходит: автору, которому нужно не просто получить MP3, а сразу собрать видео с закадровым текстом. Если монтаж выполняется на Windows и озвучка — один из этапов ролика, такой путь короче, чем связка из нескольких приложений.
2. NaturalReader — чтение PDF, EPUB и документов с разделением личного и коммерческого использования
NaturalReader полезен прежде всего как инструмент прослушивания документов. Он принимает PDF, EPUB, DOC/DOCX, PPT/PPTX и другие типы файлов, умеет распознавать текст на изображениях в платных планах и доступен через веб-приложение, мобильные приложения и расширение Chrome. Это не просто поле «вставить текст и скачать голос»: рабочий процесс построен вокруг библиотеки документов, навигации и длительного прослушивания.
Платформа: веб-приложение, мобильные приложения, расширение Chrome.
Русский язык: есть среди поддерживаемых языков голосовых моделей.
Стоимость: есть бесплатный план. Для персональной версии Lite стоит $13,90 в месяц или $79 в год, Plus — $20,90 в месяц или $119 в год, Pro — $25,90 в месяц или $159 в год. Коммерческий AI Voice Generator — отдельный продукт с собственными тарифами от $29 в месяц.
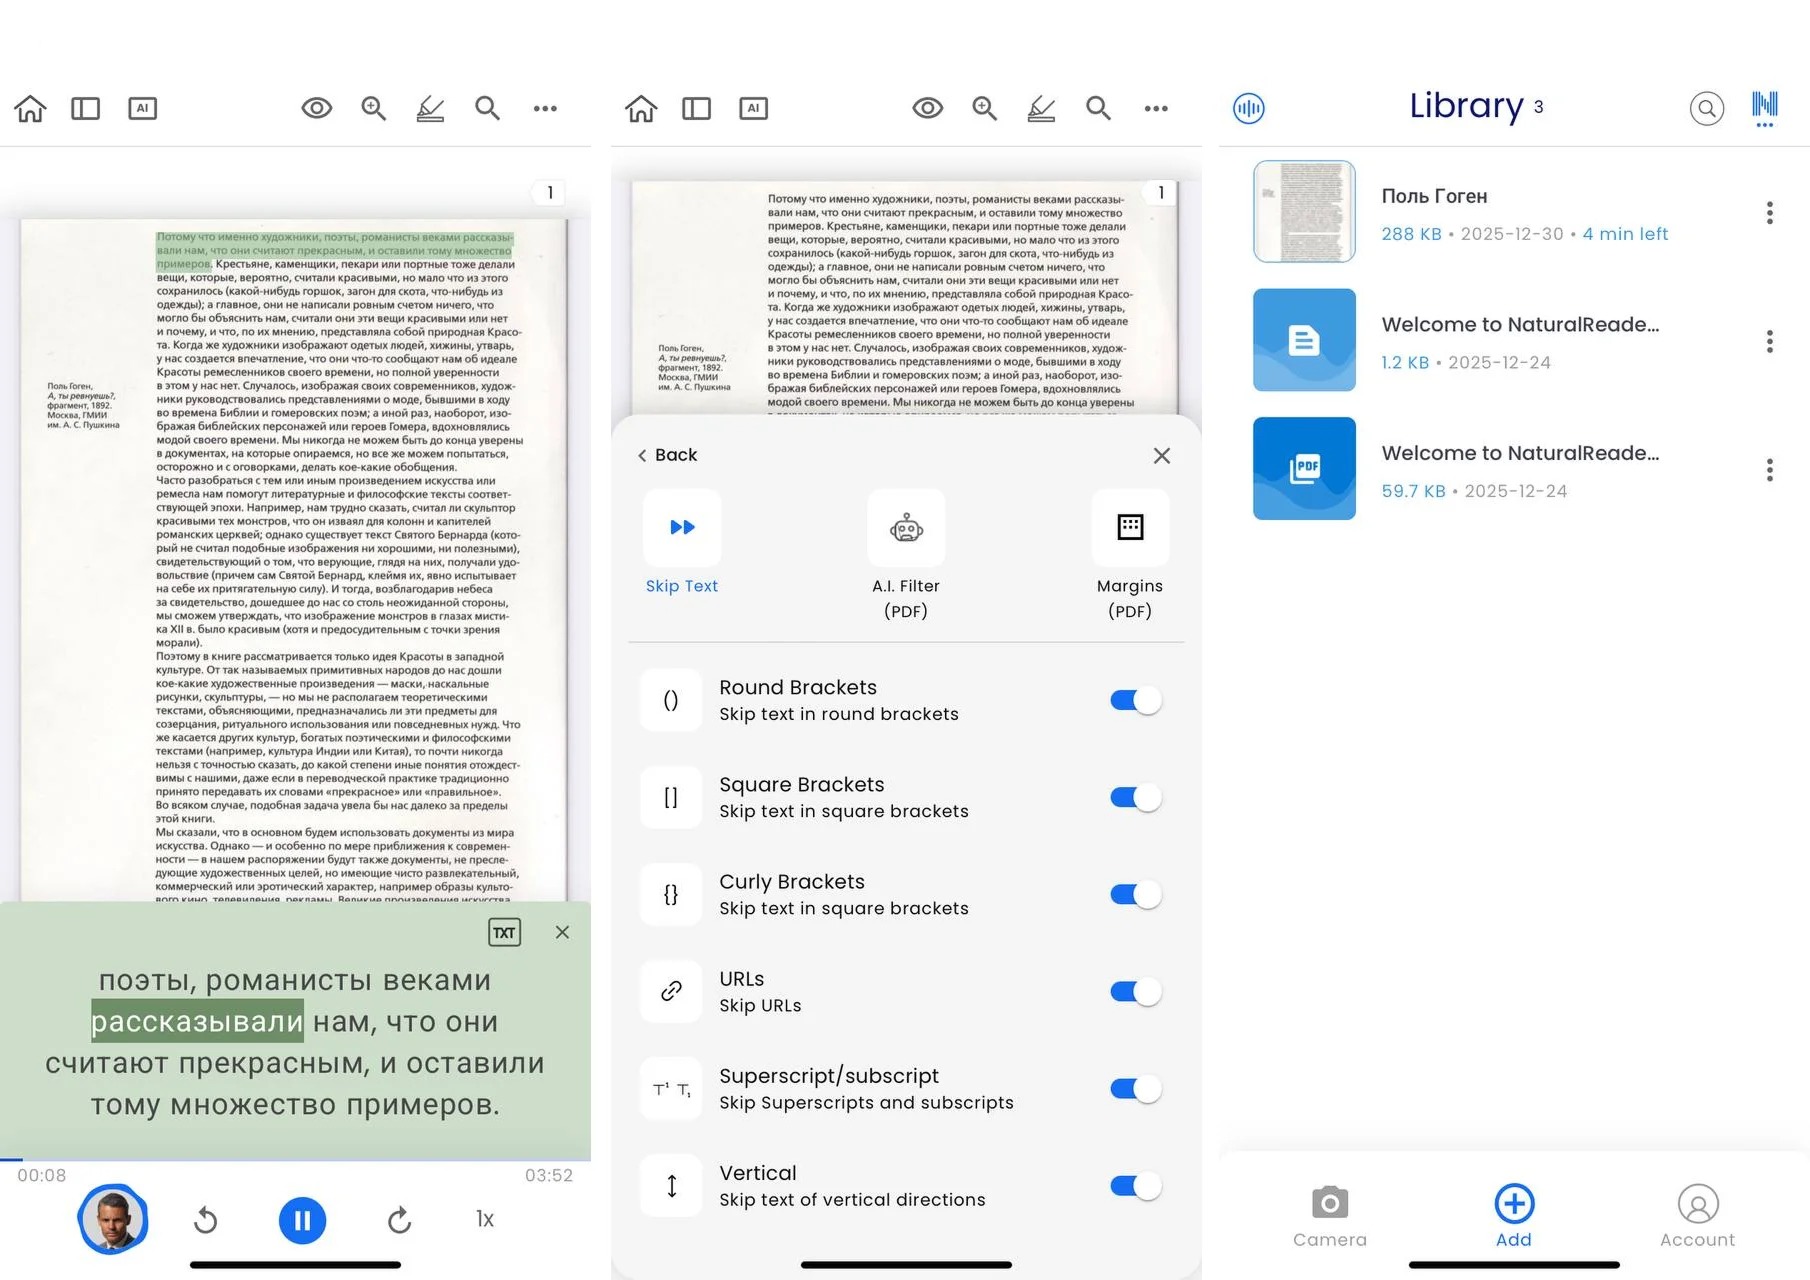
Главный нюанс NaturalReader связан с лицензией результата. Персональная версия предназначена для личного прослушивания. Даже платная подписка на Personal не дает права использовать созданное аудио в роликах, подкастах, презентациях для распространения или других публикациях. Для такого сценария нужен отдельный коммерческий AI Voice Generator. Это важнее разницы между Lite, Plus и Pro: ошибиться здесь проще, чем в выборе голоса.
Бесплатный план позволяет слушать системные голоса без лимита и дает ограниченный объем более современных голосов, но не конвертирует результат в MP3 и не включает OCR. Lite добавляет MP3 для Lite Voices и распознавание отсканированных документов; Plus и Pro расширяют набор голосов и лимиты. Поэтому бесплатная версия хорошо показывает, удобна ли сама модель чтения, но не является полноценным способом подготовить аудиофайл для дальнейшего монтажа.
Кому подходит: студентам, редакторам, исследователям и всем, кто хочет слушать PDF, презентации, электронные книги и отсканированные материалы. Для YouTube, рекламы или курса нужно сразу смотреть не Personal, а коммерческий AI Voice Generator.
3. Звукограм — русскоязычный онлайн-синтез с оплатой за фактический объем
Звукограм работает в браузере и делает акцент на производстве готовых аудиофайлов. В редактор можно вставить текст или загрузить DOCX, PDF, TXT и субтитры SRT, VTT, SUB. Доступны управление скоростью, тоном и громкостью, паузы, фоновая музыка, разметка произношения и режим диалога с несколькими голосами. Готовый результат скачивается в MP3, WAV, OGG или Opus.
Платформа: веб-сервис.
Русский язык: есть; русский доступен наряду с другими языками и мультиязычными голосами.
Стоимость: без регистрации можно озвучить 1000 символов. 1 токен равен 1 рублю; стандартные голоса стоят от 1,4 токена за 1000 символов, PRO — 5–10 токенов, HD — 14 токенов за 1000 символов. Подписка не обязательна, коммерческая лицензия включена в тарифы.
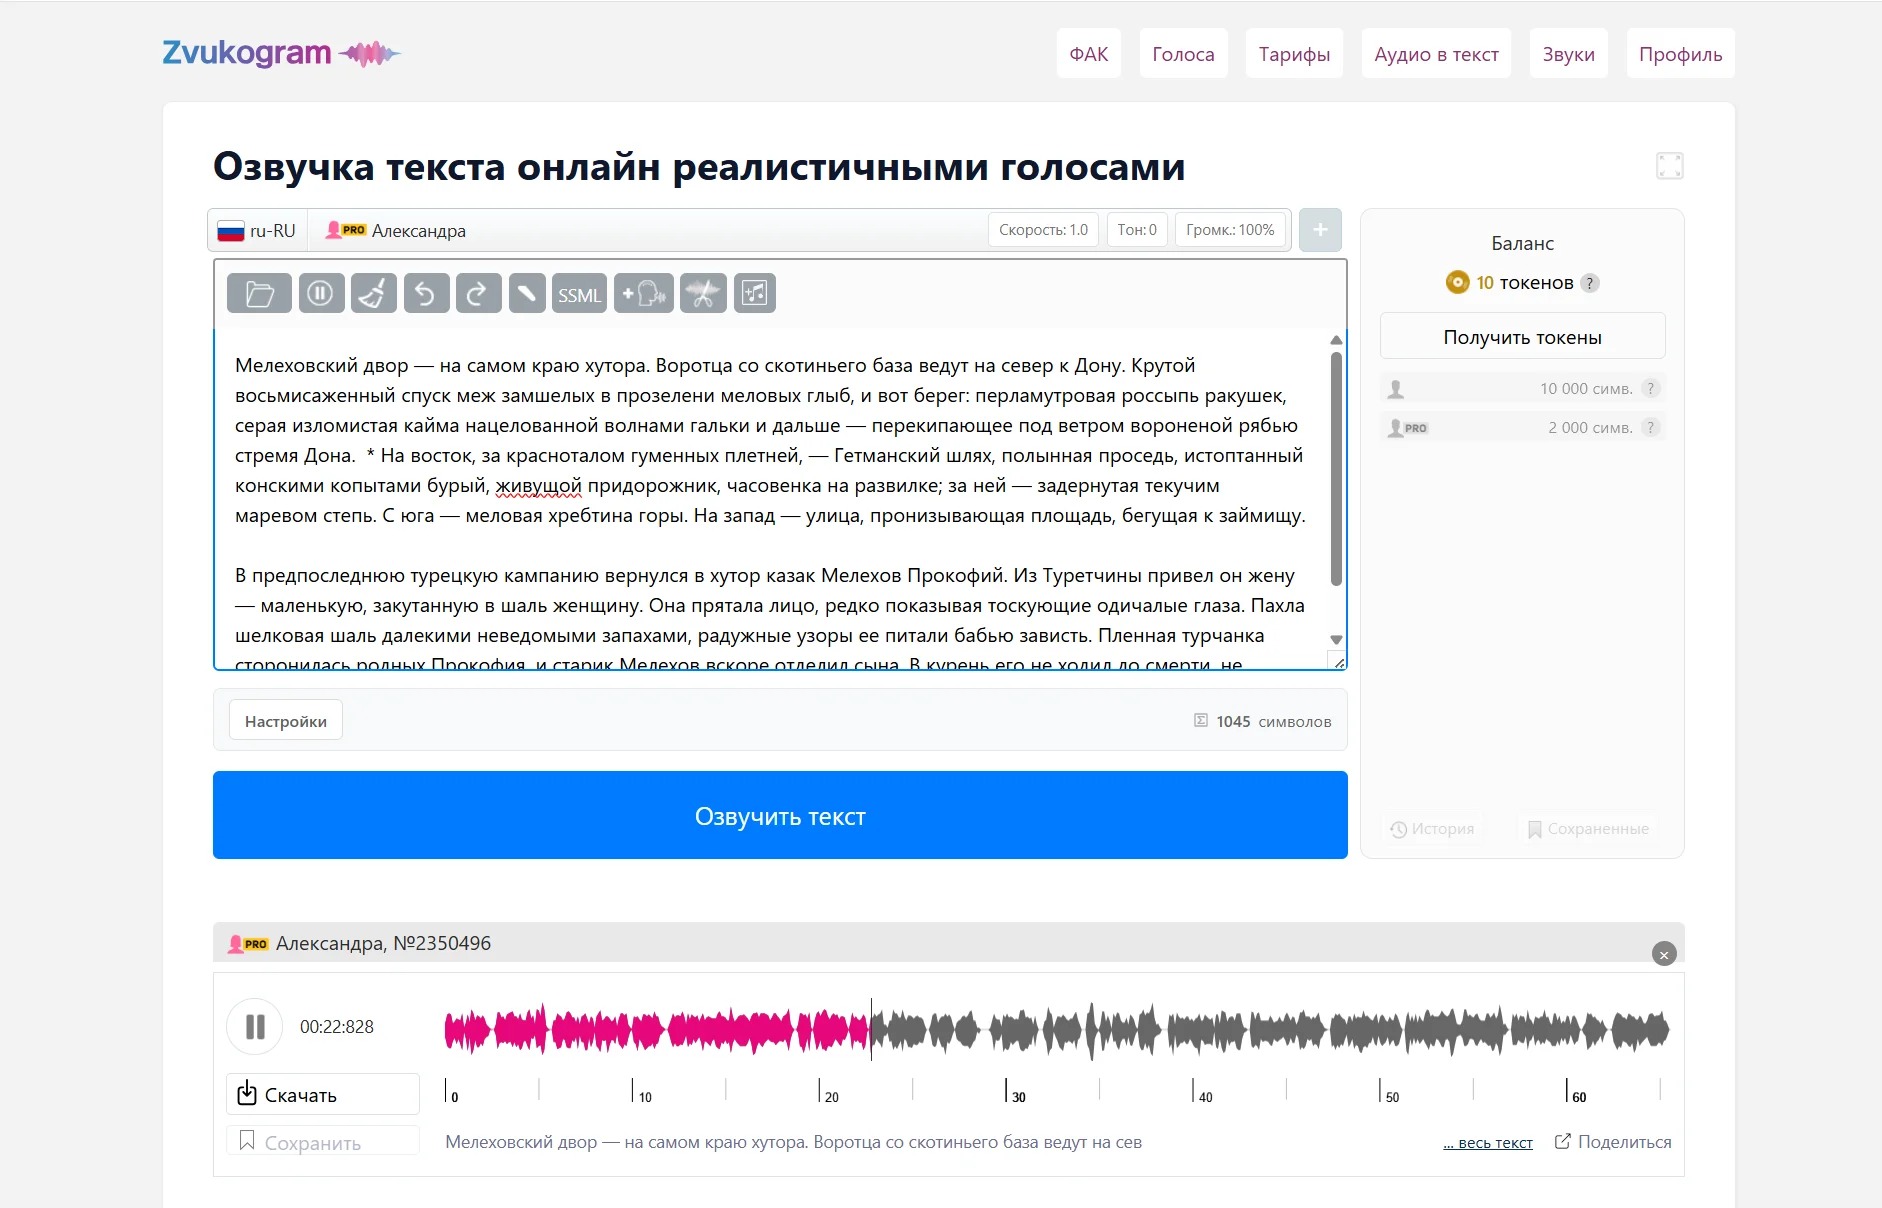
Для русского текста полезна ручная постановка ударения: знак «+» ставится перед ударной гласной. Для более сложного управления доступна SSML-разметка. Диалог собирается в одном тексте: пользователь добавляет нескольких дикторов и назначает им фрагменты. Это практичнее, чем по отдельности генерировать десятки реплик, а затем вручную собирать их в аудиоредакторе.
Система оплаты удобна для нерегулярной работы: настройки и прослушивание демонстрационных примеров не списывают средства, а оплачивается сам синтез. При правке уже озвученного текста сервис умеет учитывать измененный фрагмент, хотя смена голоса или параметров приводит к новой генерации. Для больших сценариев это помогает контролировать расходы лучше, чем подписка, которая нужна лишь несколько раз в месяц.
Кому подходит: автору русскоязычных роликов, аудиогидов, учебных материалов и диалоговых сцен, которому нужны готовые файлы и понятная оплата по объему без обязательной ежемесячной подписки.
4. Murf AI — браузерная студия для озвучки с проектами и медиаматериалами
Murf AI ближе к производственной студии, чем к простой кнопке преобразования текста. В проекте сценарий разбивается на блоки, для них выбираются голоса и параметры, а результат синхронизируется с таймлайном и медиаматериалами. Сервис поддерживает русскую речь, более 200 голосов и свыше 30 языков и акцентов. Для русского TTS доступны регулировка скорости, высоты, пауз, произношения и других параметров подачи.
Платформа: браузерная Murf Studio.
Русский язык: есть.
Стоимость: Free дает 10 минут генерации и 10 проектов, но не разрешает скачивание и коммерческое использование. Creator при оплате за год стоит $19 в месяц, Business — $66 в месяц; платные планы открывают скачивание и коммерческие права.
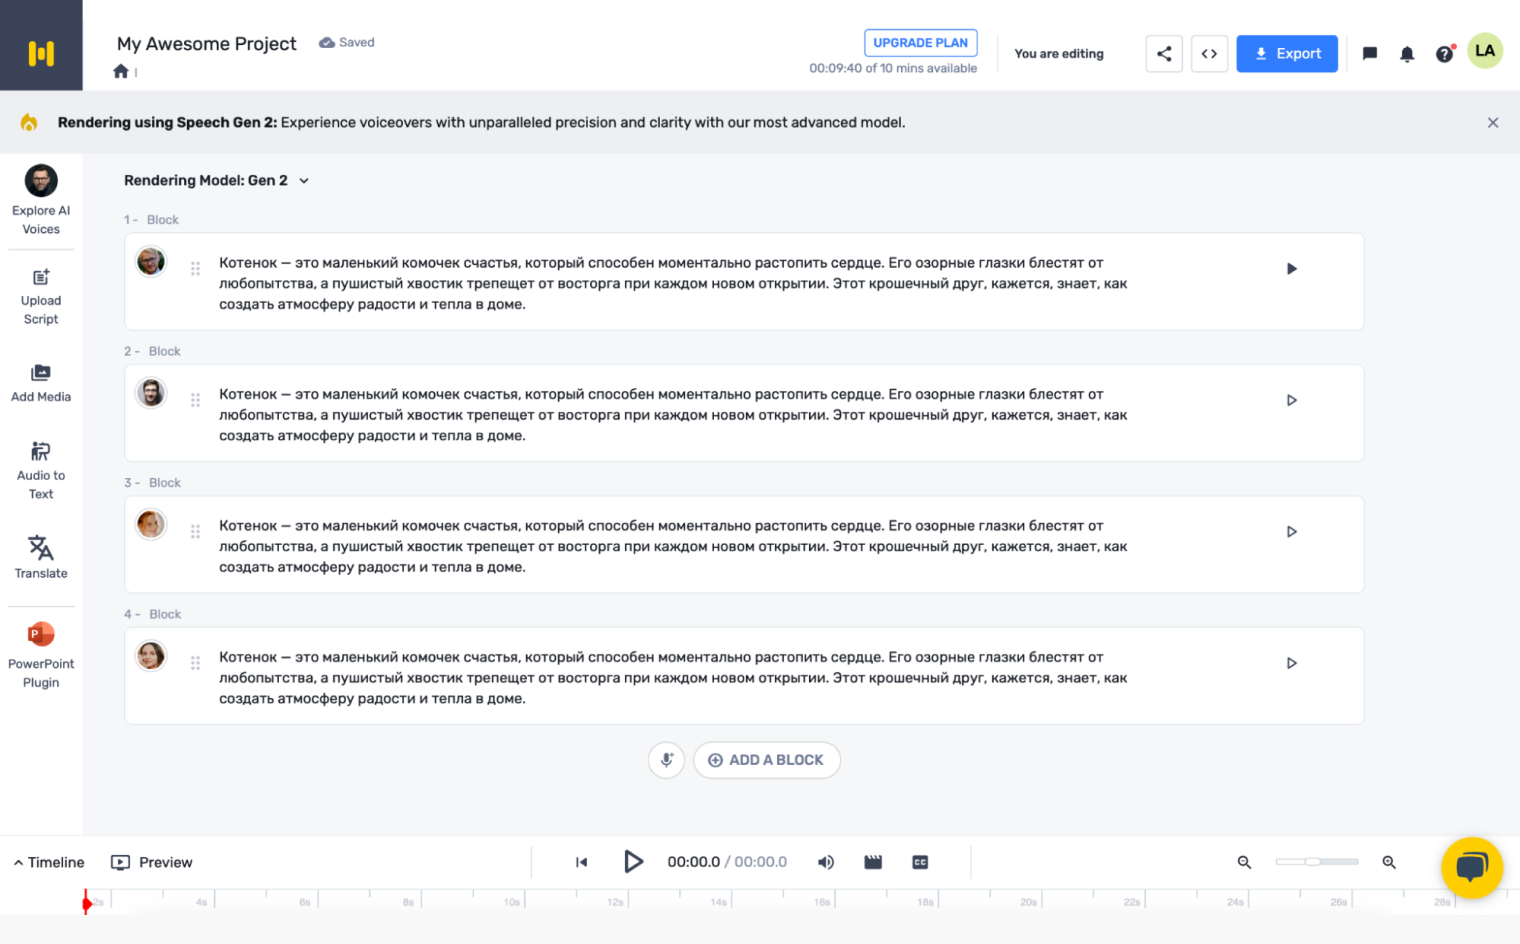
Бесплатный план лучше воспринимать как среду для оценки голосов и интерфейса, а не как способ закончить реальный проект: в нем отключено скачивание. Для выпуска ролика нужен платный план. Creator рассчитан на индивидуальную работу и дает 24 часа генерации в год, все 200+ голосов и неограниченное число скачиваний; Business добавляет дополнительные средства управления подачей и рассчитан на больший объем.
Murf полезен, когда сценарий постоянно уточняется. Вместо одного длинного текста можно держать реплики отдельными блоками, менять конкретные фразы и собирать итог в пределах проекта. Такой подход снижает риск перегенерировать весь материал из-за одной ошибки в названии бренда или цифре. Для презентаций и обучающих роликов также удобно, что аудио и визуальные материалы можно вести в одной рабочей среде.
Кому подходит: авторам курсов, презентаций, продуктовых роликов и регулярного видеоконтента, которым нужно управлять множеством реплик в рамках одного проекта, а не генерировать их по одной.
5. ElevenLabs — выразительная нейросетевая речь, Studio и клонирование голоса
ElevenLabs объединяет быстрый Text to Speech, Studio для больших проектов, Voice Design, клонирование голоса, дубляж и API. Русский язык поддерживается в многоязычных моделях. В обычном генераторе можно выбрать голос, настроить скорость, стабильность, сходство и стилистическую выразительность, затем прослушать и скачать результат. Для длинных проектов Studio удобнее одиночных генераций: материал остается структурированным, а разные фрагменты можно дорабатывать отдельно.
Платформа: веб-приложение, мобильные приложения, API и SDK.
Русский язык: есть; русский входит в число поддерживаемых языков TTS.
Стоимость: Free — $0 и 10 000 кредитов в месяц. Starter — $6 в месяц и включает коммерческую лицензию и Instant Voice Cloning. Creator — $22 в месяц, при этом для первого месяца на странице тарифа указана цена $11.
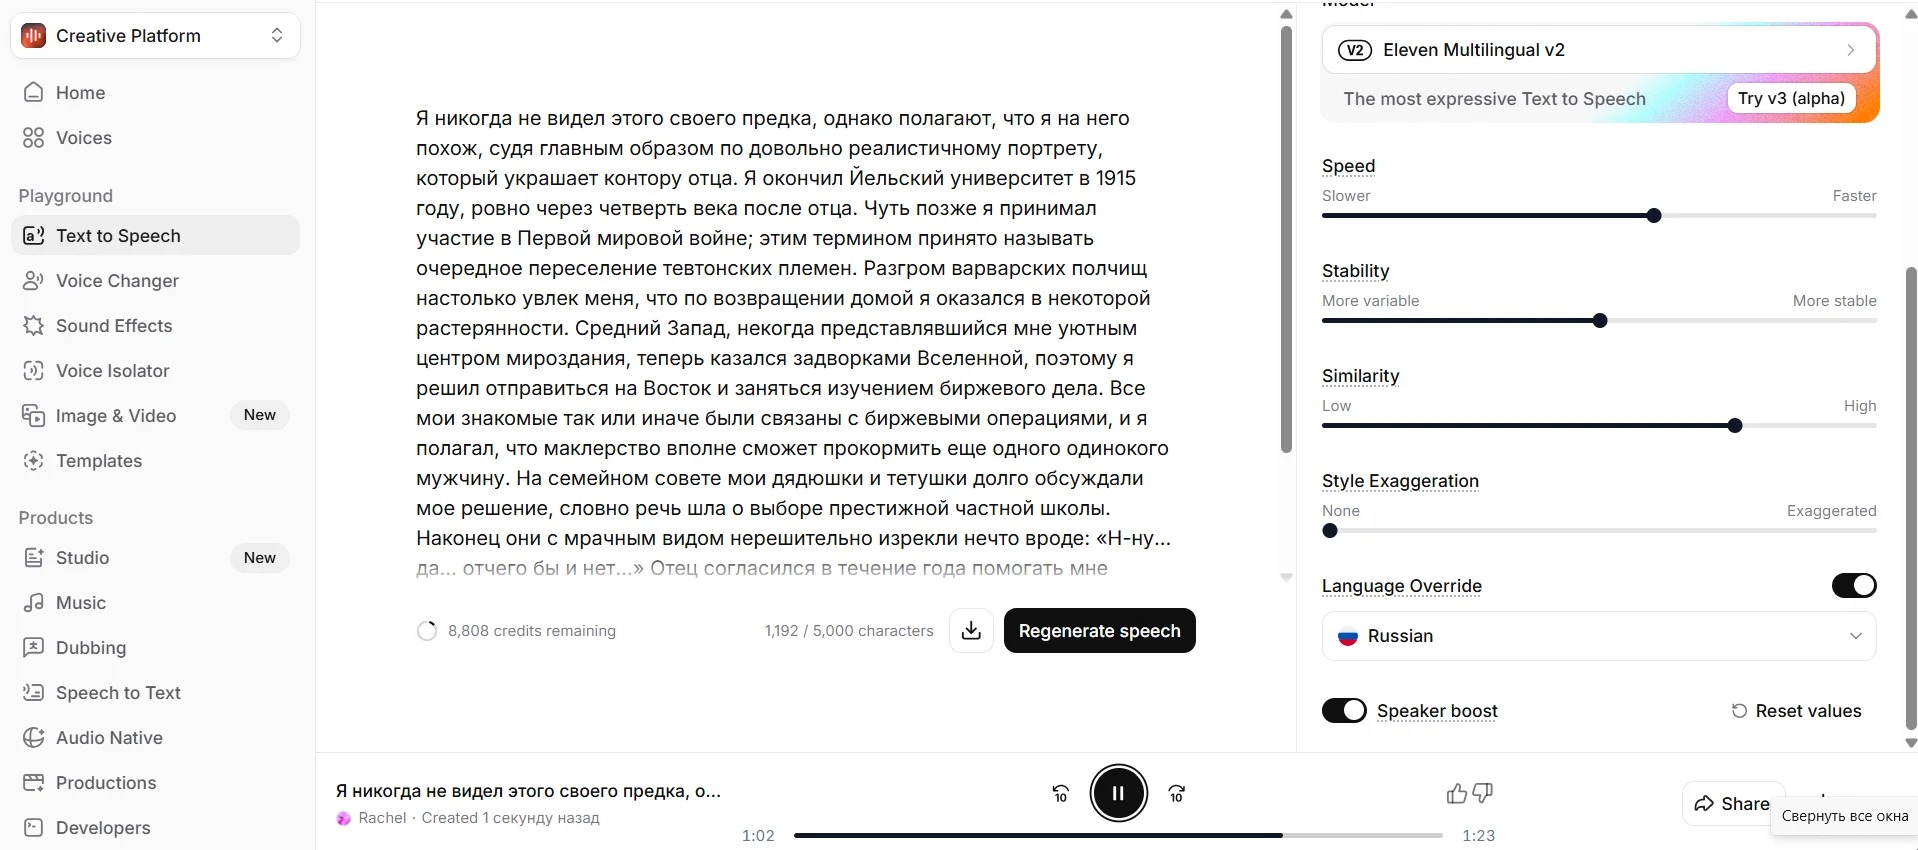
Бесплатная редакция полезна для знакомства с моделями, но коммерческая лицензия начинается со Starter. Это нужно учитывать до монтажа: если дорожка предназначена для публичного ролика или другого коммерческого использования, тариф должен соответствовать задаче уже на этапе генерации. Клонирование тоже относится к функциям, где важны не только технические настройки, но и право использовать исходный голос.
Сервис особенно силен в ситуациях, где механически ровная дикторская подача звучит неуместно: персонажная речь, художественный фрагмент, реклама, подкастовая вставка. При этом выразительность увеличивает число переменных. Один и тот же текст стоит проверять целиком, потому что отдельные слова могут звучать хорошо в изоляции, но темп, паузы и эмоциональные переходы проявляются только в контексте соседних предложений.
Кому подходит: создателям роликов, аудиокниг, подкастов и персонажного контента, которым важны выразительность, Studio и возможность затем автоматизировать генерацию через API.
6. Speechify — чтение документов на разных устройствах
Speechify логичнее выбирать как персональную читалку, а не как основную студию постпродакшена. Сервис превращает в речь веб-страницы, документы и отсканированный текст, синхронизирует процесс между устройствами и позволяет менять скорость чтения. На актуальной странице тарифов бесплатный план ограничен TTS и десятью базовыми голосами, а Premium открывает более 1000 голосов, свыше 60 языков, Scan & Listen и дополнительные функции.
Платформа: веб, приложения для Windows, macOS, iOS и Android, расширения Chrome и Edge.
Русский язык: есть; на русскоязычной странице TTS доступны русские голоса.
Стоимость: есть Free. Premium при помесячной оплате стоит $29 в месяц.
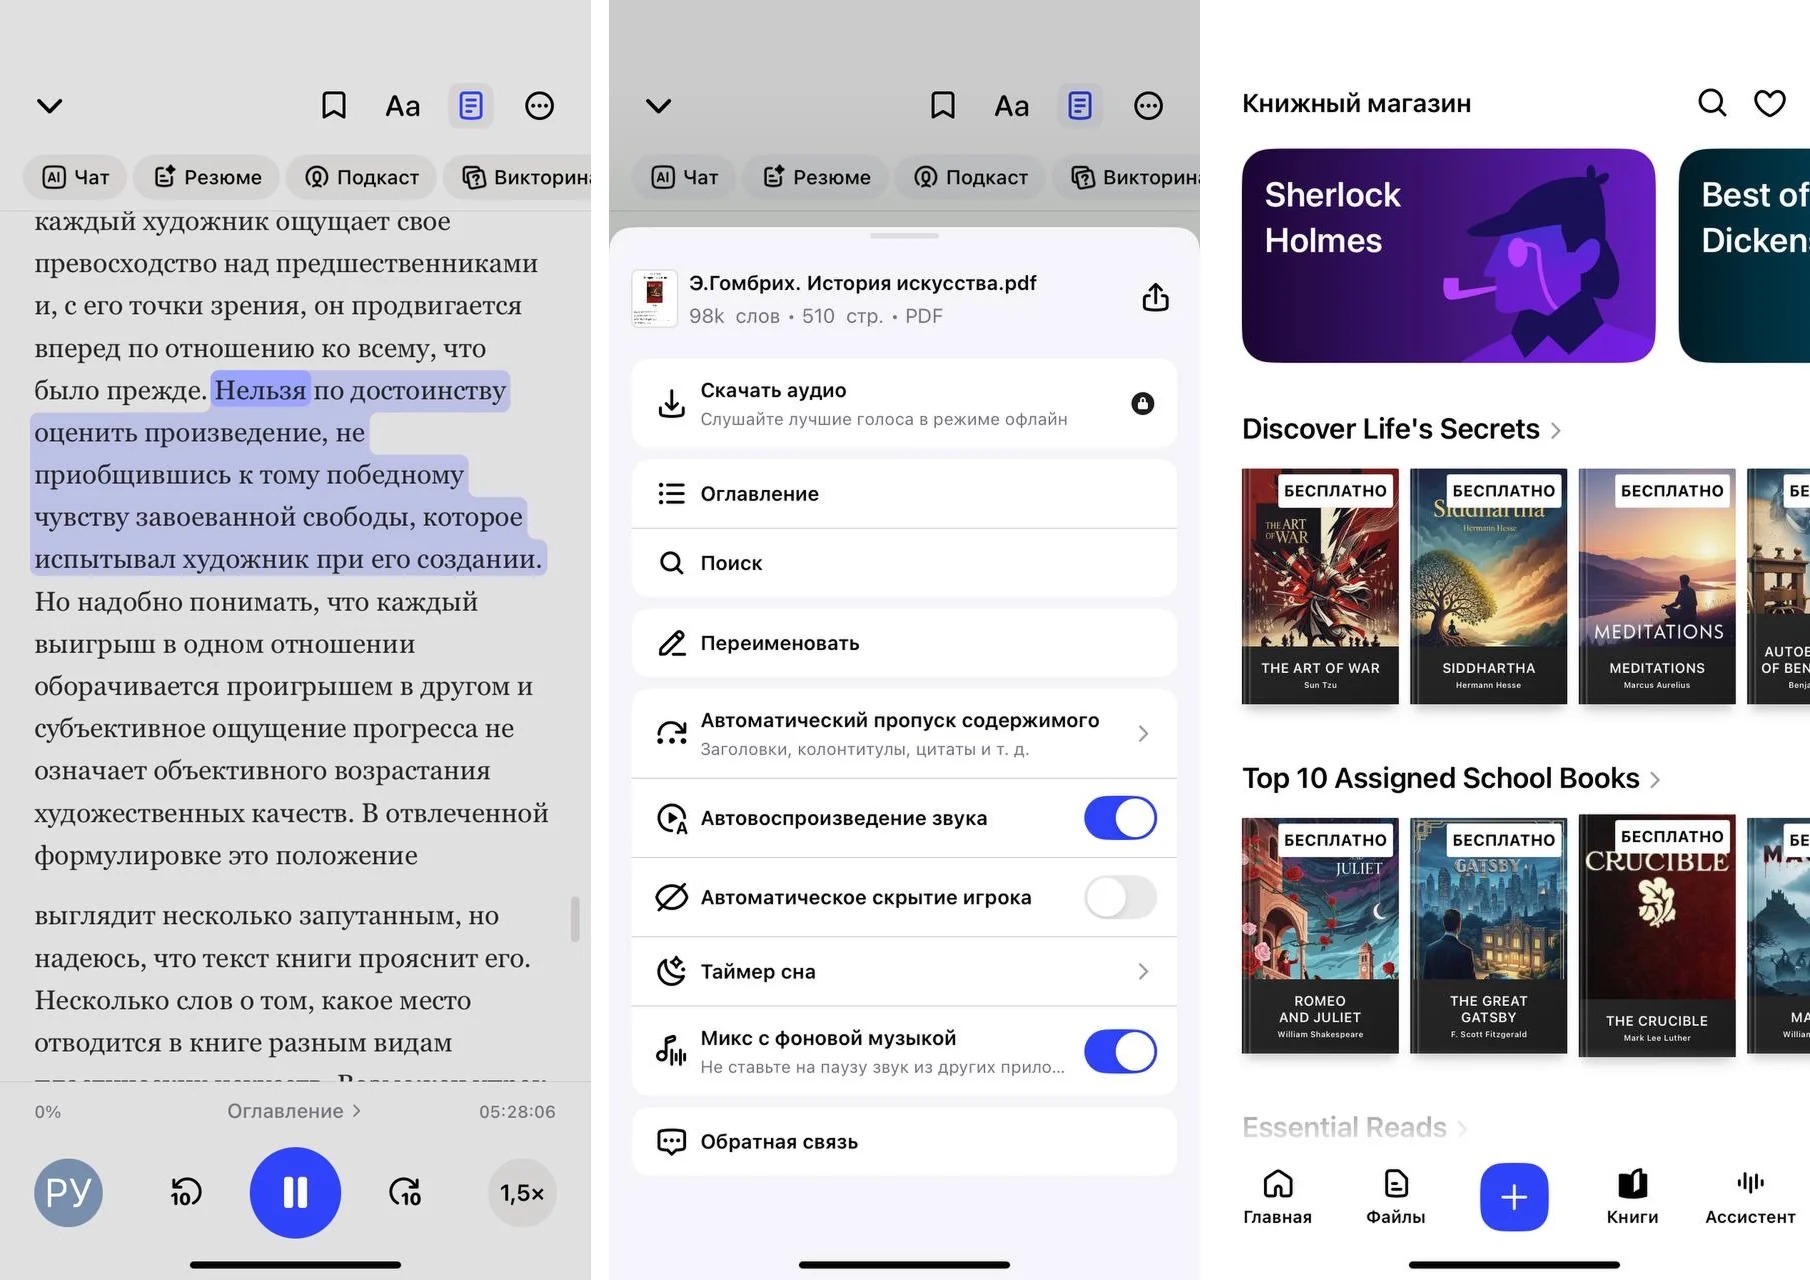
Главное достоинство такого формата проявляется не при создании одного рекламного ролика, а при постоянном чтении. Можно открыть документ на одном устройстве, прослушивать его в дороге, сканировать печатную страницу камерой и менять скорость воспроизведения под сложность материала. Русский доступен среди поддерживаемых языков, поэтому сервис подходит не только для англоязычных текстов.
У Speechify есть отдельный продукт Studio для создателей, но читательская подписка и студийное производство — разные сценарии. В рейтинге Speechify рассматривается именно как TTS-читалка: это помогает не приписывать плану Premium функции и права, которые относятся к другой линейке. Если задача — регулярно выпускать озвученные ролики, нужно отдельно сравнивать условия Speechify Studio с Murf AI, ElevenLabs или другим производственным сервисом.
Кому подходит: пользователю, который прежде всего слушает книги, статьи, учебные материалы и рабочие документы. Для выпуска озвученного контента лучше сразу выбирать производственную линейку или отдельную TTS-студию.
7. Yandex SpeechKit — облачный синтез для приложений, ботов и автоматизации
Yandex SpeechKit отличается от большинства позиций тем, что его сильная сторона — не готовая программа для монтажа, а облачная инфраструктура. Синтез можно протестировать в SpeechKit Playground, а затем подключить через REST или gRPC API. Для русского языка доступен набор голосов с разными амплуа; в API можно задавать голос, роль, скорость, высоту и нормализацию громкости, а произношение корректировать TTS-разметкой.
Платформа: Yandex Cloud, веб-интерфейс SpeechKit Playground, REST и gRPC API.
Русский язык: есть; для русского доступны многочисленные голоса и амплуа.
Стоимость: оплата по фактическому использованию; принцип и ставка зависят от региона и версии API. В API v1 синтез учитывается по числу символов, в API v3 — по числу расчетных единиц обращений к API.
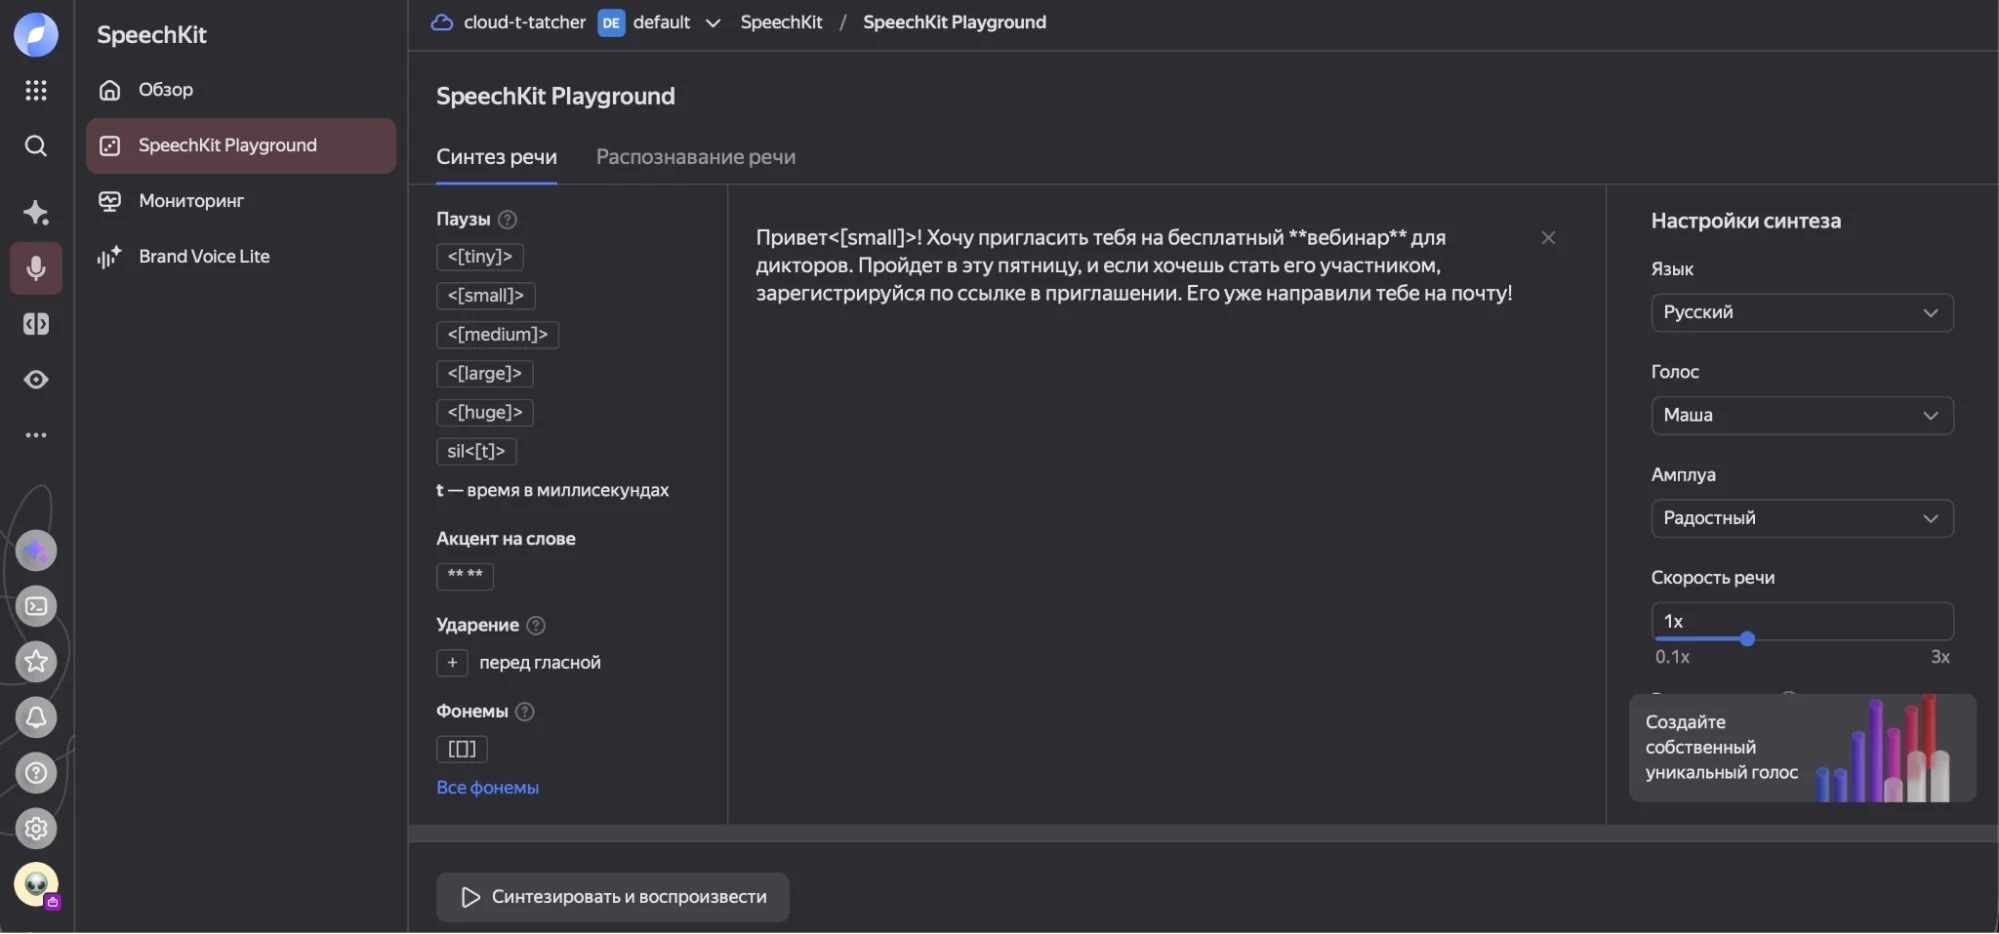
Для первой проверки не обязательно сразу писать код. В Playground выбираются язык, голос, амплуа, скорость и другие параметры, после чего запускается «Синтезировать и воспроизвести». Готовый результат можно скачать. Когда базовых настроек становится мало, тот же процесс переносится в API: это важно для сервисов, где озвучка генерируется не вручную, а по данным из CMS, чат-бота, каталога или системы обучения.
API v3 поддерживает WAV и более гибкие параметры синтеза, включая TTS-разметку и нормализацию. Для разработчика это плюс, для автора одного ролика — лишняя сложность. Перед выбором SpeechKit нужно честно ответить, требуется ли автоматизация. Если в месяц создается несколько коротких дорожек вручную, браузерная TTS-студия проще. Если озвучивается постоянно меняющийся массив данных, API становится преимуществом.
Кому подходит: разработчикам и командам, которым синтез речи нужен как компонент продукта или повторяемого производственного процесса. Для одиночной ручной озвучки его потенциал используется не полностью.
8. Balabolka — локальная Windows-оболочка над установленными голосами
Balabolka не содержит собственных голосов. Программа использует речевые движки, установленные в Windows через Microsoft Speech API. Именно поэтому качество результата определяется прежде всего выбранным TTS-движком, а не интерфейсом Balabolka. Приложение берет на себя работу с текстом: открывает большой набор документов, управляет чтением, меняет скорость и высоту, применяет словари замен и сохраняет синтез в аудиофайл.
Платформа: Windows; есть обычная, portable- и консольная версии.
Русский язык: доступен при установленном русскоязычном SAPI-голосе; сама программа голосовые модели не поставляет.
Стоимость: для некоммерческого использования программа бесплатна. Коммерческая лицензия Balabolka стоит €80; право коммерчески распространять речь конкретного голосового движка проверяется отдельно у его поставщика.
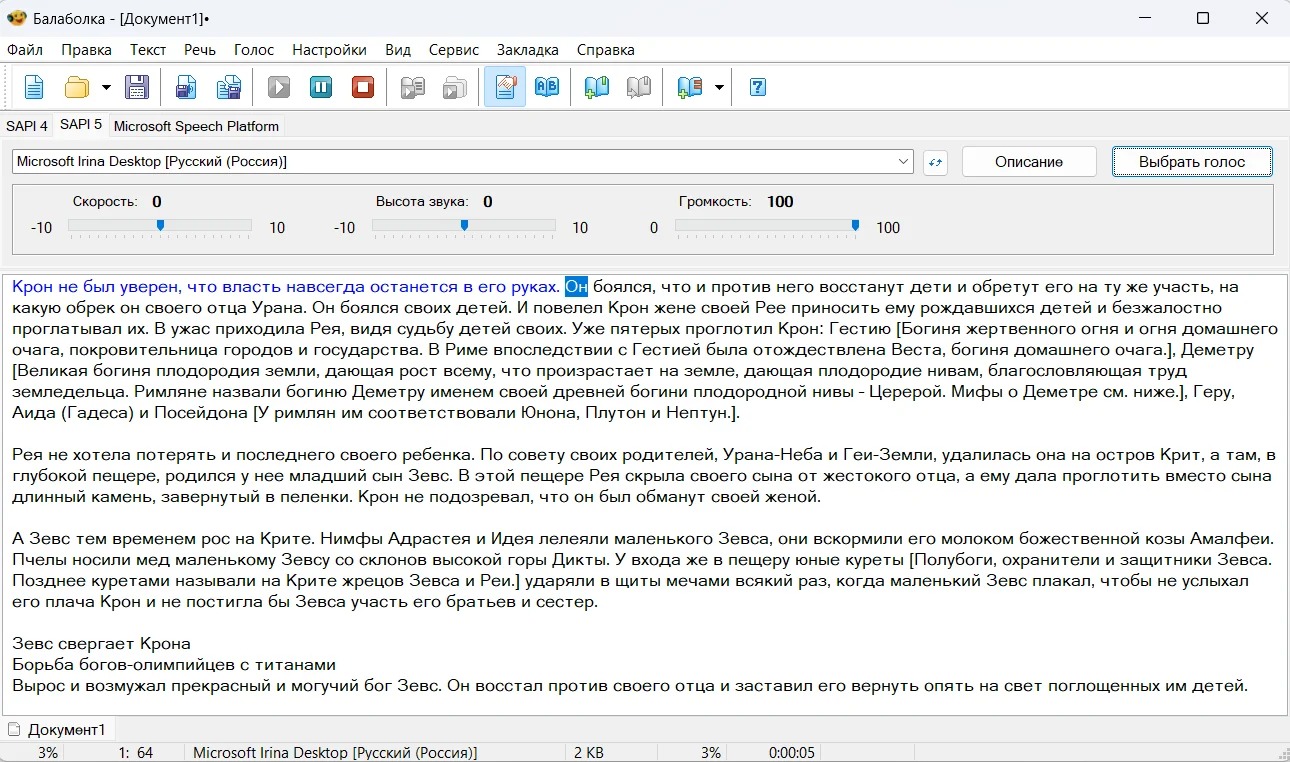
Программа читает содержимое буфера обмена и поддерживает длинный список форматов, среди которых DOC/DOCX, PDF, EPUB, FB2, MOBI, PPT/PPTX, ODT, XLS/XLSX и HTML. Для документов это удобно: текст не нужно вручную переносить в веб-форму. Словарь замен и регулярные выражения помогают исправлять повторяющиеся ошибки произношения, например специфические фамилии, сокращения или названия продуктов.
Локальный характер Balabolka полезен там, где не хочется каждый раз загружать документ в браузерный сервис. Но «локально» не означает «любой голос работает офлайн»: программа использует то, что установлено в системе, а дополнительные облачные движки подключаются отдельными средствами. На Windows 11 более естественные системные голоса можно добавить в SAPI через вспомогательный NaturalVoiceSAPIAdapter, который отдельно описан разработчиком.
Кому подходит: пользователю Windows, которому нужен локальный инструмент для чтения больших документов, пакетной подготовки аудио и тонкой коррекции произношения без обязательной подписки на браузерную студию.
Как выбрать TTS под конкретную задачу
Универсального варианта нет, потому что слово «озвучка» скрывает разные конечные результаты. Сначала определите, что должно появиться после работы: дорожка внутри видеопроекта, файл для публикации, персональное прослушивание документа или автоматический голосовой ответ в приложении.
| Задача | Что важнее всего | Подходящие варианты |
|---|---|---|
| Озвучить ролик и сразу подогнать реплики под кадры | Таймлайн, работа с видео и звуком в одном проекте | ВидеоМОНТАЖ |
| Слушать PDF, книги и статьи | Импорт документов, мобильность, скорость чтения | NaturalReader, Speechify |
| Получать русскоязычные MP3/WAV без монтажа | Ударения, диалоги, паузы, понятная оплата | Звукограм |
| Вести большие голосовые проекты в браузере | Сцены, блоки, версии реплик, коммерческие права | Murf AI, ElevenLabs |
| Озвучивать данные автоматически | API, стабильная схема интеграции, параметры аудио | Yandex SpeechKit, ElevenLabs API |
| Работать с документами на Windows через системные голоса | Локальные файлы, SAPI, словари произношения | Balabolka |
Для видеопроизводства отдельно учитывайте этап после синтеза. Даже хороший голос не решает монтажную задачу: нужно проверить начало и конец реплик, уровень относительно музыки, паузы между сценами и совпадение смысла с изображением. Если проект сложнее возможностей простого редактора, аудиофайл можно собрать отдельно, а затем продолжить работу в DaVinci Resolve. Для полностью бесплатного нелинейного монтажа подойдет Kdenlive, а синхронизацию и правку субтитров удобно вынести в Subtitle Edit.
Проверка синтезатора за 15 минут
Демонстрационная фраза из двух предложений почти ничего не говорит о пригодности сервиса. Перед оплатой или запуском большого проекта подготовьте короткий тестовый сценарий, который намеренно содержит сложные элементы. Так быстрее выявляются проблемы с произношением и становится понятна реальная трудоемкость правок.
- Соберите тест на 40–60 секунд. Добавьте обычный повествовательный абзац, вопрос, число с единицами измерения, дату, аббревиатуру, иностранное имя и одно слово с неоднозначным ударением. Для видео включите фразу, которую нужно уложить в точный интервал.
- Выберите один нейтральный голос. Не начинайте сравнение с эмоций и эффектов. Сначала оцените дикцию, естественность пауз и читаемость согласных. Если базовая подача не подходит, стилизация редко исправляет фундаментальную проблему.
- Исправьте произношение штатными средствами. В Звукограме можно ставить знак перед ударной гласной и использовать SSML; в NaturalReader есть Pronunciation Editor; Balabolka поддерживает словари замен; SpeechKit позволяет использовать TTS-разметку. Сравнивайте не наличие пункта меню, а сколько действий требуется для повторяющихся исправлений.
- Проверьте вторую генерацию. Измените одно предложение и создайте звук заново. Для регулярной работы важно, можно ли быстро заменить фрагмент, не пересобирая всю дорожку и не теряя структуру проекта.
- Скачайте доступный формат. Для дальнейшей обработки предпочтителен несжатый или качественный исходник, когда сервис его предоставляет. MP3 подходит для готовой речи и предварительного монтажа, но повторное перекодирование через несколько этапов нежелательно.
- Проверьте лицензию именно своего плана. Бесплатный доступ не означает право публиковать аудио. NaturalReader Personal рассчитан на личное прослушивание, у Murf Free нет коммерческих прав, а ElevenLabs добавляет коммерческую лицензию со Starter.
- Вставьте дорожку в реальный проект. Прослушайте ее вместе с музыкой, шумами и изображением. Реплика, которая кажется естественной отдельно, может оказаться слишком медленной для монтажа или теряться на фоне других звуков.
Этот короткий тест полезнее сравнения рекламных демо: он использует ваш язык, ваши имена и вашу длину реплик. После него видно, где потребуется ручная коррекция и сколько времени она займет на десятках фрагментов.
Как подготовить текст, чтобы синтез речи звучал естественнее
TTS читает не авторский замысел, а конкретную последовательность символов и разметки. Поэтому сценарий для синтеза стоит редактировать иначе, чем статью. Длинная фраза, нормально воспринимаемая глазами, может звучать монотонно; сокращение, понятное человеку, может быть прочитано буквально; перенос строки иногда влияет на паузу сильнее, чем запятая.
Разбивайте длинные предложения
Если предложение занимает несколько строк и содержит три-четыре смысловых поворота, разделите его на две реплики. Синтезатору проще построить интонацию на коротком завершенном фрагменте. Для видео это дополнительно упрощает монтаж: короткий блок легче сдвинуть, ускорить или перегенерировать, не затрагивая соседнюю сцену.
Числа и сокращения записывайте так, как их нужно услышать
Особенно внимательно проверяйте модели камер, денежные суммы, даты, размеры, единицы измерения и смешанные латинско-кириллические обозначения. Если сервис неправильно произносит конструкцию, безопаснее переписать ее фонетически понятной формой или применить редактор произношения, чем надеяться, что другой голос автоматически исправит ошибку.
Паузы задавайте смыслом, а не количеством знаков
Многоточия и цепочки запятых дают непредсказуемый результат в разных движках. Там, где сервис поддерживает явные паузы или TTS/SSML-разметку, лучше использовать их. В обычном редакторе работайте абзацами и отдельными репликами. Так длительность проще контролировать, а текст остается читаемым.
Не усиливайте эмоцию на каждом предложении
Выразительная модель полезна для персонажа, рекламы или художественного фрагмента, но в инструкции постоянные эмоциональные скачки отвлекают от содержания. Сначала добейтесь стабильного темпа и ясной дикции, затем добавляйте стиль только в тех местах, где он действительно поддерживает смысл.
Чек-лист перед экспортом озвучки
- Произношение. Прослушайте имена, бренды, географические названия, аббревиатуры и числа отдельно от остального текста.
- Темп. Проверьте не только среднюю скорость, но и самые насыщенные фактами предложения. Если слушатель перестает успевать воспринимать числа, лучше сократить формулировку, а не ускорять весь ролик.
- Паузы. Между смысловыми блоками должна оставаться заметная граница. В монтаже слишком короткую паузу проще уменьшить, чем восстановить отсутствующее естественное дыхание внутри слитной фразы.
- Громкость. Сравнивайте речь с музыкой и эффектами в одном проекте. Сам по себе громкий файл не гарантирует разборчивость после сведения.
- Формат. Если предстоит дополнительная обработка, сохраняйте максимально качественный доступный исходник. Финальный сжатый формат создавайте после монтажа, а не на каждом промежуточном этапе.
- Версия текста. Перед последней генерацией сверяйте сценарий с субтитрами и монтажным листом. Одна старая цифра в голосовой дорожке означает новый синтез и повторную синхронизацию.
- Права использования. Убедитесь, что текущий тариф разрешает именно тот способ распространения, который планируется: личное прослушивание, открытая публикация, реклама, обучение или коммерческий проект.
Типичные проблемы и способы диагностики
| Симптом | Что проверить | Безопасное решение |
|---|---|---|
| Неправильное ударение | Есть ли редактор произношения, знак ударения, словарь замен или TTS-разметка | Исправить одно проблемное слово штатным способом и сохранить правило для повторений |
| Речь звучит слишком ровно | Длина предложений, выбранный стиль, паузы между блоками | Разделить сценарий на короткие реплики и только затем менять выразительность |
| Реплика не помещается в сцену | Темп, количество вводных слов, длительность пауз | Сначала сократить формулировку, затем умеренно изменить скорость; не ускорять весь ролик из-за одной сцены |
| После скачивания файл нельзя использовать в публикации | Лицензию именно выбранного плана, а не наличие кнопки Download | Перейти на план с нужными правами или сгенерировать дорожку заново в подходящей редакции |
| Голос хорошо звучит отдельно, но теряется в ролике | Музыку, фоновые шумы, громкость и частотную конкуренцию | Сводить речь вместе с остальным звуком, уменьшить фон и оставить запас по уровню |
| Длинный документ трудно исправлять | Можно ли делить текст на проекты, блоки, главы или отдельные файлы | Разбить материал до генерации и хранить понятные названия фрагментов |
| Онлайн-сервис становится дорогим на длинных текстах | Модель тарификации: символы, кредиты, минуты или подписка | Посчитать объем сценария до начала и выбирать класс голоса по назначению, а не максимальное качество для каждой тестовой версии |
| Balabolka произносит русский хуже ожидаемого | Какой SAPI-движок выбран в Windows | Сменить или установить другой совместимый голос; интерфейс Balabolka сам по себе качество модели не меняет |
Как встроить TTS в рабочий процесс видеомонтажа
Для ролика лучше начинать не с окончательного голоса, а с предварительной озвучки. Сначала соберите сценарий по сценам, сгенерируйте нейтральную дорожку и проверьте тайминг. На этом этапе удобно сокращать предложения, переносить фразы между кадрами и уточнять длительность планов. Только после утверждения структуры имеет смысл тратить более дорогие кредиты на финальный голос или вручную доводить произношение.
В ВидеоМОНТАЖЕ этот цикл выполняется внутри одного проекта. При использовании отдельного TTS-сервиса сохраняйте каждый смысловой блок отдельным файлом и называйте его по номеру сцены: например, 01_intro, 02_demo, 03_result. Такой порядок упрощает повторную генерацию. В сложном проекте голос можно свести в DaVinci Resolve с инструментами Fairlight, а для короткого социального контента использовать CapCut Desktop. Если важна браузерная работа с субтитрами и облачным экспортом, отдельный вариант — VEED.io.
Субтитры лучше готовить из того же утвержденного сценария, из которого делалась финальная речь. Тогда меньше расхождений между тем, что зритель слышит и видит. После автоматической разметки обязательно проверить имена, числа и границы фраз: синхронная текстовая дорожка должна совпадать с реальным аудио, а не только с исходным документом.
Что важнее количества голосов
Каталог из сотен или тысяч голосов полезен только до тех пор, пока можно быстро найти подходящий и стабильно воспроизводить нужную манеру. Для регулярной работы важнее четыре свойства: предсказуемое произношение, возможность локально исправить ошибку, сохранение структуры проекта и понятные права на результат. Если каждый новый абзац приходится заново настраивать вручную, большое число голосов не ускоряет производство.
В русской речи особое внимание стоит уделять ударениям, букве «ё», фамилиям, топонимам и словам с несколькими нормативными вариантами. Для технических роликов добавляются маркировки камер, объективов, кодеков и англоязычные названия функций. Хороший TTS-процесс — это не выбор «самого человеческого» демо, а способность регулярно исправлять такие места без пересборки всего материала.
Для постпродакшена также важен формат. WAV удобнее как промежуточный файл, когда речь еще предстоит обрабатывать и сводить; MP3 удобен как компактный готовый результат. Разница становится заметна при повторном кодировании: чем меньше промежуточных потерь, тем проще сохранить чистую дикцию и избежать лишних артефактов на шипящих и тихих окончаниях.
FAQ
Можно ли использовать бесплатную TTS-озвучку в коммерческом видео?
Не всегда. Условия различаются у каждого продукта и даже между планами одного сервиса. Например, NaturalReader Personal предназначен для личного прослушивания, у Murf Free отсутствуют коммерческие права, а ElevenLabs включает коммерческую лицензию со Starter. У Звукограм коммерческая лицензия включена в тарифы. Проверять нужно условия конкретного плана до финальной генерации.
Что лучше для монтажа: MP3 или WAV?
Для промежуточной обработки и сведения предпочтительнее WAV, когда сервис его предоставляет: это несжатый формат и он не добавляет потери при каждом новом этапе кодирования. MP3 удобен для быстрых тестов, прослушивания и ситуаций, где дополнительной обработки почти не будет. Финальное видео все равно кодирует звук в свой целевой формат, поэтому качественный исходник дает больше запаса.
Нужен ли отдельный TTS-сервис, если видеоредактор уже умеет озвучивать текст?
Не обязательно. Если встроенных голосов и настроек достаточно, озвучка внутри редактора сокращает число операций и упрощает синхронизацию. Отдельная платформа нужна, когда важны особая манера речи, крупная библиотека моделей, клонирование голоса, многоголосый проект, API или условия лицензирования, которых нет у видеоредактора.
Можно ли озвучивать документы без загрузки их в облако?
Да. Balabolka работает как локальная Windows-программа и использует установленные в системе речевые движки. При этом конкретный голос тоже должен быть доступен локально; подключение облачного движка превращает часть процесса в сетевую. Для конфиденциального документа стоит проверять не только программу-оболочку, но и способ работы выбранного голосового движка.
Вывод
Для ролика на Windows самый короткий путь дает ВидеоМОНТАЖ: текст превращается в речь там же, где собирается видеоряд. NaturalReader и Speechify сильнее как инструменты личного чтения документов и книг. Звукограм удобен для русскоязычных файлов с ручным контролем ударений и оплатой за объем. Murf AI и ElevenLabs лучше раскрываются в регулярном производстве, где важны проекты, версии реплик, выразительные модели и права на публикацию. Yandex SpeechKit имеет смысл, когда синтез становится частью приложения или автоматизированного конвейера. Balabolka остается практичным локальным вариантом Windows, если уже выбран подходящий SAPI-голос.
Перед оплатой стоит проверить не десяток демонстрационных голосов, а один собственный фрагмент со сложными именами, числами и реальным таймингом. Затем нужно скачать файл, вставить его в рабочий проект и отдельно проверить условия использования. Именно этот короткий цикл показывает, какой TTS-инструмент действительно уменьшает число ручных правок и подходит под ваш способ выпуска контента.