Плохую запись редко портит что-то одно: в интервью одновременно слышны кондиционер, комната гудит на низких частотах, голос то проваливается, то становится слишком громким, а удалённый собеседник звучит заметно хуже ведущего. Нейросети упрощают такую обработку, но разные сервисы решают разные части задачи. Одни восстанавливают разборчивость речи, другие разделяют голос и фон, третьи выравнивают громкость и приводят выпуск к целевому уровню, а четвёртые работают прямо во время звонка.
Ниже собраны инструменты, которые регулярно применяются именно к речи, подкастам, интервью и звуку в видео. Нумерация помогает ориентироваться в материале, а не объявляет один сервис безусловным победителем: результат зависит от характера дефекта, исходной записи и дальнейшего монтажа. АудиоМАСТЕР стоит первым как локальный настольный вариант для ручной обработки. Это не специализированная облачная нейросеть уровня Adobe Podcast или LALAL.AI, зато он полезен, когда нужен обычный аудиоредактор с шумоподавлением, эквалайзером, монтажом и конвертацией на Windows.
Главное правило для любого ИИ-улучшения — хранить исходник отдельно. Алгоритм способен сделать речь субъективно чище, но не возвращает достоверно те детали, которых микрофон вообще не записал. При сильном шуме, перегрузе или далёком голосе часть сигнала реконструируется, поэтому в финальном файле возможны металлические обертоны, «съеденные» согласные и неестественные паузы. Для видеопроизводства это особенно важно: после очистки дорожку ещё предстоит синхронизировать с изображением и свести с музыкой. Для такого продолжения работы можно использовать DaVinci Resolve для монтажа, цвета и звука.
- Коротко: чем отличаются инструменты
- 1. АудиоМАСТЕР — локальная ручная обработка вместо облачной нейросети
- 2. Adobe Podcast Enhance Speech — восстановление речи и раздельный контроль фона
- 3. Auphonic — автоматический постпродакшен и контроль loudness
- 4. Krisp — шумоподавление во время звонка, а не ремонт готового файла
- 5. LALAL.AI Voice Cleaner — отделение голоса от шума, музыки и микрофонных помех
- 6. Cleanvoice AI — очистка речи плюс автоматический монтаж пауз и артефактов
- 7. Audo Studio — минималистичная очистка шума и Auto Volume
- 8. Descript — Studio Sound внутри текстового монтажа
- 9. Async — бывший Podcastle с Magic Dust AI и многодорожечным редактором
- Как выбрать нейросеть по характеру проблемы
- Постоянный шум: вентилятор, кондиционер, шипение
- Сильная комната и далёкий микрофон
- Фоновая музыка или другой голос
- Разная громкость ведущего и гостя
- Онлайн-встреча или удалённое интервью
- Подкаст с паузами, дыханием и словами-паразитами
- Как проверить нейросеть за 15 минут
- Что сохранять на каждом этапе
- Типичные артефакты ИИ-очистки и как их распознать
- Голос стал металлическим или «под водой»
- Пропали окончания слов и тихие согласные
- Фон начинает «дышать» между фразами
- После автоматического удаления пауз речь стала нервной
- Музыка превратилась в шорох
- После улучшения появился клиппинг
- Чек-лист перед экспортом
- Частые вопросы
- Можно ли нейросетью восстановить перегруженный звук?
- Повысится ли качество, если перед загрузкой перевести MP3 в WAV?
- Нужно ли сначала нормализовать громкость, а потом удалять шум?
- Что выбрать для конфиденциального разговора?
- Какой сервис удобнее для звука с камеры?
- Подходит ли ИИ-очистка для музыки?
- Что выбрать в итоге
- Предложить модель для рейтинга
Коротко: чем отличаются инструменты
| Инструмент | Основная задача | Тип обработки | Бесплатный старт | Главный компромисс |
|---|---|---|---|---|
| АудиоМАСТЕР | Ручная очистка, монтаж и конвертация | Настольный редактор | Есть бесплатная загрузка программы | Не является специализированным ИИ-реставратором речи |
| Adobe Podcast Enhance Speech | Восстановление разборчивости речи и подавление фона | Облачный ИИ | До 30 минут на файл и до 1 часа в день | Точный контроль и пакетная обработка относятся к платному плану |
| Auphonic | Финальная обработка выпуска: шум, уровень, loudness | Облачная постобработка | 2 часа в месяц | В бесплатном режиме к результату добавляется фирменный джингл |
| Krisp | Шумоподавление во время звонков и встреч | ИИ в реальном времени | 7-дневный пробный период | Не предназначен для постобработки готовой записи |
| LALAL.AI Voice Cleaner | Отделение голоса от шума и фоновой музыки | Облачное разделение источников | 10 минут для тестового предпросмотра | Полный результат на бесплатном плане не скачивается |
| Cleanvoice AI | Очистка подкаста, пауз, дыхания и слов-паразитов | Облачная автоматическая редактура | 30 минут | Автоматические монтажные склейки требуют прослушивания |
| Audo Studio | Быстрое удаление фонового шума и выравнивание громкости | Облачный ИИ | 20 минут в месяц | Набор функций уже, чем у комплексных редакторов |
| Descript | Монтаж речи по тексту плюс Studio Sound | Редактор с ИИ | Бесплатный план с ограниченными ИИ-функциями | Продвинутые инструменты расходуют лимиты платных планов |
| Async | Многодорожечный подкаст и Magic Dust AI | Облачный редактор с ИИ | Есть план Free | Magic Dust рассчитан прежде всего на речь, а не на музыкальный мастеринг |
Если нужен только чистый голос из одной проблемной записи, разумно начинать с Adobe Podcast или LALAL.AI. Для выпуска подкаста, где после шумоподавления ещё надо стабилизировать уровни и громкость, удобнее Auphonic. Krisp решает другую задачу: он очищает звук до того, как собеседник услышит его в Zoom, Teams или другой программе связи. Descript, Cleanvoice и Async ближе к полноценному производственному процессу, потому что совмещают улучшение звука с монтажом речи.
1. АудиоМАСТЕР — локальная ручная обработка вместо облачной нейросети
Платформа: Windows 11, 10, 8, 7 и XP.
Язык интерфейса: русский.
Лимиты: программу можно скачать бесплатно; постоянная лицензия приобретается отдельно.
Цена: разовая покупка; доступны редакции «Стандарт», «Премиум» и «Платинум».
АудиоМАСТЕР — настольный аудиоредактор, а не узкий сервис нейросетевой реставрации речи. Его сильная сторона в другом: запись можно открыть как обычный звуковой файл, выделить проблемный участок, вырезать лишнее, изменить громкость, применить эквалайзер и инструменты удаления дефектов, а затем сохранить результат в нужном формате. Поддерживаются MP3, WAV, AAC, WMA, OGG, FLAC, M4R и другие распространённые форматы; отдельно предусмотрены запись с микрофона, смешивание дорожек и извлечение аудио из видео.
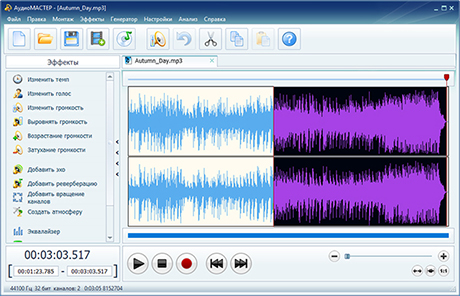
Для улучшения проблемной речи здесь полезны не обещания «в один клик», а возможность работать дозированно. Сначала стоит найти участок, где шум слышен без голоса, затем оценить, насколько агрессивно нужно чистить запись. После этого выровнять громкость и проверить тембр эквалайзером. Такой процесс медленнее автоматического Enhance Speech, зато оператор контролирует, какой участок меняется и в какой момент.
Редактор особенно уместен, когда вместе с очисткой нужно нарезать диктофонную запись, соединить несколько дублей, убрать длинные паузы вручную или подготовить аудиодорожку для дальнейшего видеомонтажа. Для сложного проекта с несколькими микрофонами и автоматическим выравниванием собеседников он менее удобен, чем Auphonic, Cleanvoice или полноценная монтажная система.
Подходит для: владельца Windows, которому нужен понятный локальный редактор для подрезки, шумоподавления, эквализации и конвертации, а не отдельный облачный сервис. Это полезный базовый вариант и для тех случаев, когда нейросеть после очистки слишком сильно меняет голос и приходится возвращаться к более контролируемой обработке.
2. Adobe Podcast Enhance Speech — восстановление речи и раздельный контроль фона
Платформа: веб-сервис в браузере.
Язык интерфейса: сайт и Studio доступны на нескольких языках, включая английский, французский, немецкий, итальянский, испанский и португальский.
Лимиты: Free — аудио до 30 минут и 500 МБ, не больше 1 часа улучшения в день; по одному файлу за раз.
Цена: базовый Enhance Speech доступен бесплатно; расширенные возможности входят в Adobe Firefly Pro с доступом к Adobe Podcast Premium.
Enhance Speech v2 предназначен именно для речи: модель снижает фоновый шум и реверберацию, подтягивает далёкий голос и старается сохранить характер говорящего. Это отличает инструмент от обычного шумового фильтра, который только ослабляет частоты или строит профиль постоянного шума. Сервис полезен для интервью на улице, записей в комнате с голыми стенами, звука с камеры и голосовых дорожек, где микрофон оказался дальше от спикера, чем планировалось.
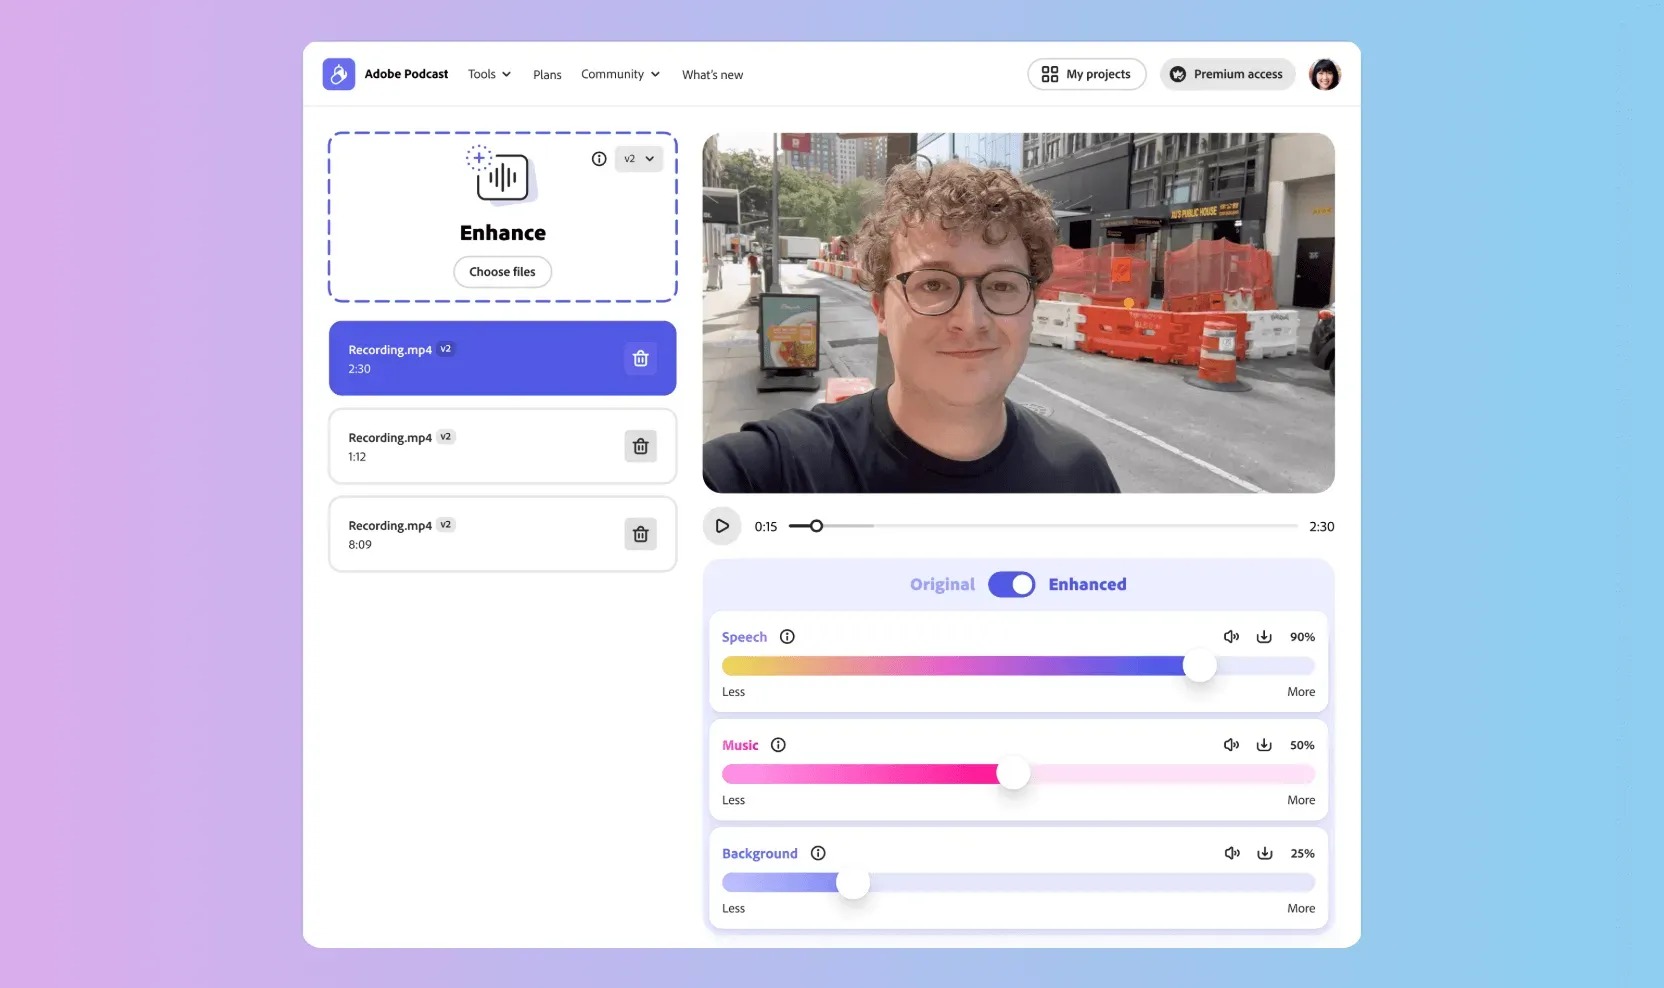
В бесплатном режиме обработка максимально проста: загружается один аудиофайл, после расчёта можно сравнить исходный и улучшенный варианты. Регулировка силы эффекта относится к расширенному плану. Это важное ограничение: на сложной записи стопроцентная «чистота» не всегда звучит естественно. Если оставить немного атмосферы помещения и снизить интенсивность обработки, речь часто воспринимается натуральнее.
В обновлении марта 2026 года Premium получил расширенное разделение источников. Сервис независимо управляет речью, фоновой средой и музыкой, а также позволяет выгружать соответствующие стемы. Для видеографа это заметно расширяет сценарий: не обязательно полностью вырезать атмосферу улицы или зала — её можно оставить тише, убрать только мешающую музыку и затем собрать финальный баланс в монтажной программе. Premium принимает также видео, поддерживает пакетную загрузку, увеличивает предел до 2 часов и 1 ГБ на файл и разрешает обрабатывать до 4 часов в день.
- бесплатный режим не даёт регулировать силу улучшения и не обрабатывает видео;
- при сильно повреждённом исходнике модель способна изменить тембр, окончания слов или фонетические детали;
- файлы обрабатываются через веб-сервис, поэтому для конфиденциальной записи нужно отдельно оценивать требования проекта к облачной обработке.
Подходит для: интервью, подкаста, закадрового текста и talking-head-видео, где главная цель — быстро сделать речь разборчивее. Перед экспортом стоит прослушать не только тихий фрагмент, но и самые громкие согласные, смех, дыхание и места, где одновременно звучит музыка: именно там чаще проявляются артефакты разделения.
3. Auphonic — автоматический постпродакшен и контроль loudness
Платформа: веб-сервис; также доступны API и командные инструменты для автоматизации.
Язык интерфейса: основной веб-интерфейс — английский; отдельные элементы встречаются на немецком.
Лимиты: Free — 2 часа обработанного аудио в месяц; бесплатные минуты не накапливаются, а к бесплатным production добавляется джингл Auphonic.
Цена: есть Free, ежемесячные пакеты Recurring Credits и одноразовые One-Time Credits.
Auphonic удобнее воспринимать не как «нейросеть, которая делает голос студийным», а как автоматического инженера финальной постобработки. Он сочетает Noise & Reverb Reduction, Intelligent Leveler, фильтрацию, de-esser и de-plosive, исправление клиппинга и артефактов кодека, а затем приводит готовую программу к заданной громкости. Для подкаста и длинного интервью такая последовательность часто важнее максимального шумоподавления: выпуск с разными уровнями ведущего и гостя утомляет даже при чистом фоне.
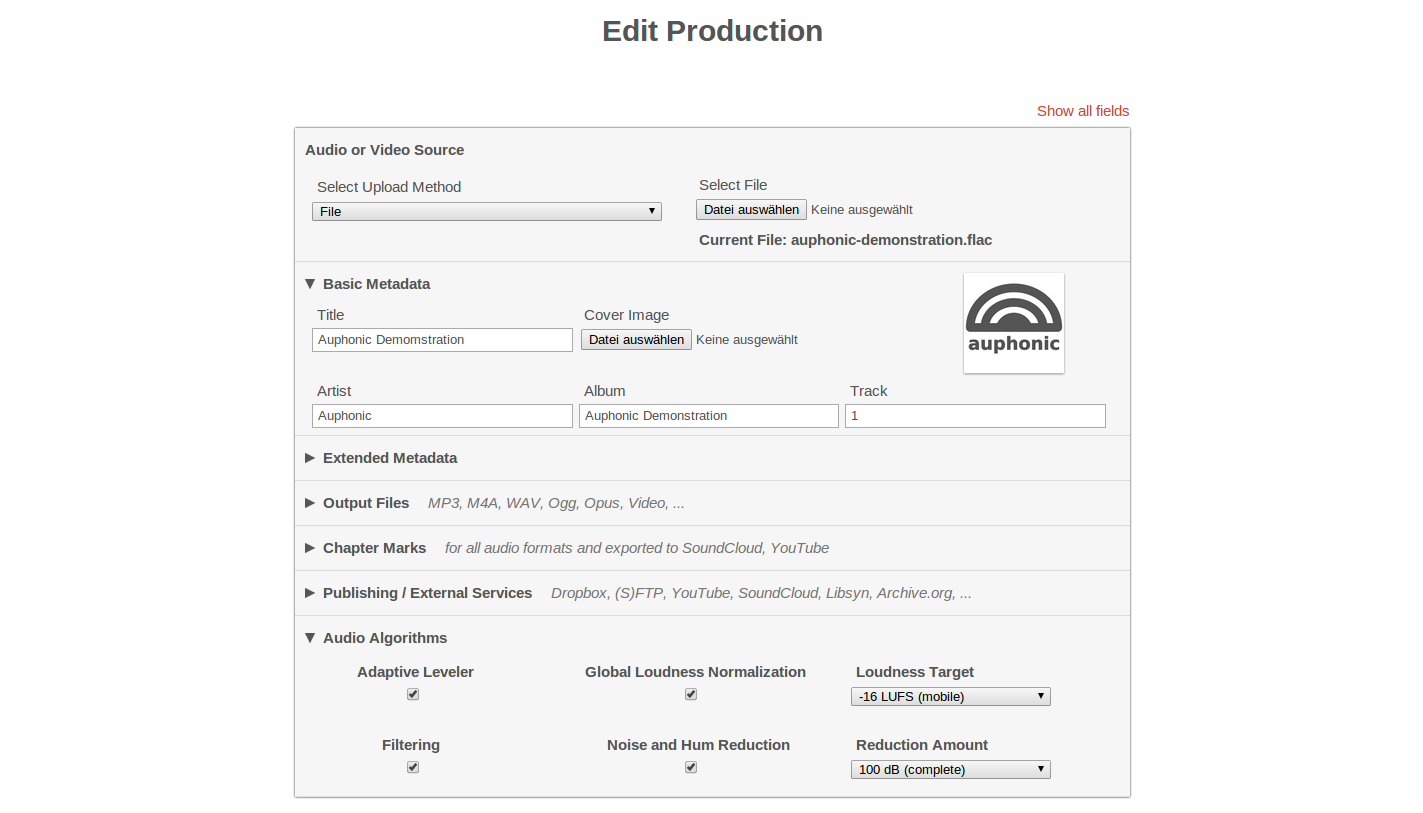
Рабочий процесс подходит для регулярного выпуска контента. Пользователь создаёт Production или preset, загружает аудио либо видео, включает нужные алгоритмы, задаёт спецификацию loudness и форматы выхода. В многодорожечном режиме сервис умеет автоматическое ducking, noise gate и снижение bleed между микрофонами. Для публикации можно подключать внешние хранилища и площадки, а в платных режимах — batch productions и watch folders.
В бесплатном тарифе доступны базовые алгоритмы, включая шумоподавление, выравнивание уровня и спецификации loudness. Но есть два существенных ограничения: только 2 часа в месяц и фирменный джингл. Для коммерческого выпуска это делает бесплатный режим скорее инструментом проверки, чем постоянным способом финального мастеринга.
Подходит для: подкастера, видеоредактора или небольшой студии, где каждый выпуск проходит одинаковые стадии: убрать шум, стабилизировать уровни разных голосов, привести итог к заданной громкости и выгрузить несколько форматов. Если после этого звук пойдёт в ролик, полезно сохранить отдельный WAV-мастер и уже его подставлять в Adobe Premiere Pro для дальнейшего видеомонтажа, чтобы не выполнять несколько поколений сжатия MP3 или AAC.
4. Krisp — шумоподавление во время звонка, а не ремонт готового файла
Платформа: настольное приложение для Windows и macOS; работает как аудиослой между микрофоном, динамиками и приложением связи.
Язык интерфейса: основной интерфейс — английский.
Лимиты: 7-дневный Free Trial; в период пробного доступа шумоподавление не ограничено.
Цена: Core — $16 за пользователя в месяц при помесячной оплате или $8 в месяц при годовой; Advanced — $30 или $15 соответственно.
Krisp принципиально отличается от остальных участников: он очищает звук в реальном времени. Приложение создаёт виртуальные микрофон и динамик, которые выбираются в программе звонков. Алгоритм может убирать шум на стороне пользователя и шум, приходящий от других участников, а Background Voice Cancellation предназначен для подавления посторонних голосов вокруг основного спикера.
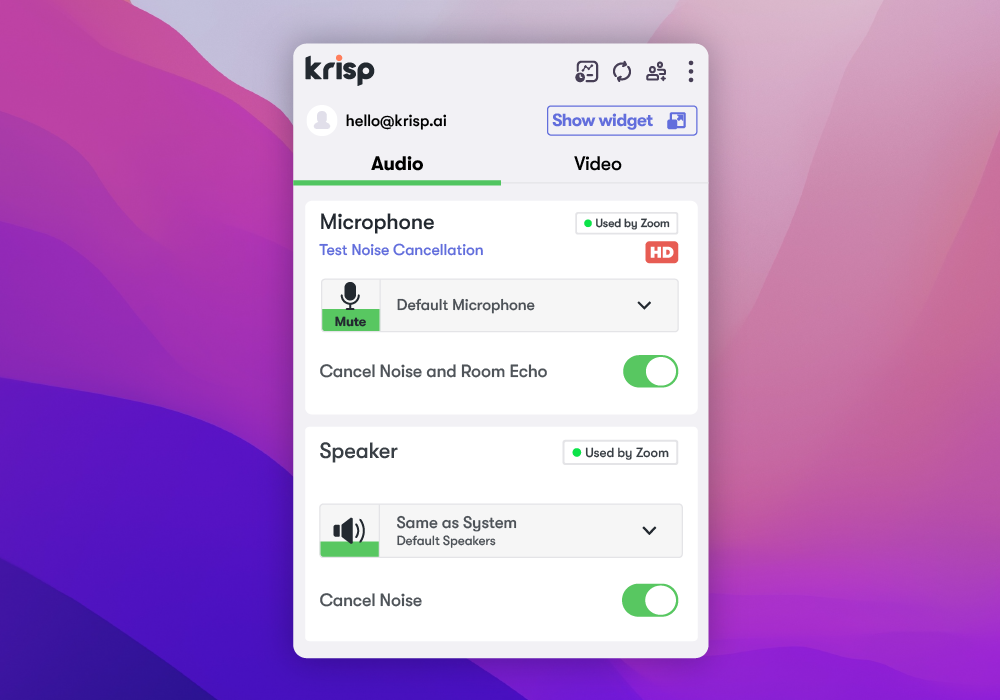
Для записи интервью через видеосвязь такой подход полезен ещё до монтажа: чистый сигнал получает и собеседник, и приложение записи. Снижается риск, что постоянный шум вентилятора, клавиатура или разговоры в комнате будут мешать коммуникации. При этом Krisp прямо отделяет свой сценарий от постпродакшена: сервис не предназначен для загрузки старой шумной записи и последующего восстановления её качества.
Шумоподавление обрабатывается на локальном устройстве; для самой функции noise cancellation аудиоданные не отправляются на сервер. Но у Krisp появились облачные функции Meeting Assistant, записи, транскрипции и заметок, поэтому конфиденциальность нужно оценивать по конкретно включённому модулю, а не переносить свойства локального шумоподавления на весь продукт.
Подходит для: удалённых интервью, онлайн-обучения, стримов и деловых встреч, когда важнее получить чистую речь на входе, чем исправлять её после записи. Если проблема уже записана в файл, рациональнее перейти к Adobe Podcast, Auphonic, LALAL.AI или Descript.
5. LALAL.AI Voice Cleaner — отделение голоса от шума, музыки и микрофонных помех
Платформа: веб-сервис; также есть приложения для Windows, macOS, iOS и Android.
Язык интерфейса: рабочий интерфейс и справка доступны в нескольких локализованных версиях; базовые названия режимов сохраняются на английском.
Лимиты: Starter — 10 минут в Relaxed Queue, файл до 200 МБ; полный результат в бесплатном плане не скачивается.
Цена: Starter — бесплатно; Lite — $9,99 в месяц или $90 в год; Pro — $19,99 в месяц или $180 в год.
Voice Cleaner вырос из технологии разделения источников LALAL.AI. Вместо классического «профиля шума» он анализирует запись и пытается выделить голос как отдельный компонент. Это особенно полезно там, где фон меняется: музыка из колонки, улица, разговоры, гул помещения, микрофонный rumble и взрывные согласные. Сервис работает и с речью, и с вокалом.
Поддерживаются MP3, OGG, WAV, FLAC, AIFF, AAC и M4A, а из видео — AVI, MP4, MKV, MOV и M4V. После загрузки можно прослушать результат, открыть настройки и выбрать уровень Noise Canceling. Чем агрессивнее режим, тем выше риск, что вместе с шумом модель затронет естественные призвуки голоса. Отдельный Echo & Reverb Remover решает другую задачу — уменьшает отражения помещения, которые уже «сидят» внутри самой речи.
Для владельцев платных планов доступны Fast minutes, а после их исчерпания обработка переключается в Relaxed Queue. Неиспользованные Fast minutes не переносятся на следующий расчётный период. В 2026 году у LALAL.AI также развивается локальная модель Lyra для desktop/VST-сценариев без загрузки файла, но Voice Cleaner как отдельный веб-процесс остаётся облачным инструментом.
Подходит для: интервью с фоновой музыкой, стримов, мобильных записей и роликов, где нужно получить максимально отдельную речевую дорожку. Для музыкального проекта важно не путать Voice Cleaner со stem splitter: первый очищает голос от нежелательного окружения, второй разделяет композицию на вокал и инструменты.
6. Cleanvoice AI — очистка речи плюс автоматический монтаж пауз и артефактов
Платформа: веб-сервис и API.
Язык интерфейса: основной веб-интерфейс — английский; обработка сигнала не зависит от языка речи.
Лимиты: стартовые 30 минут бесплатно; пакетная загрузка в аккаунте — до 5 отдельных файлов за одну операцию.
Цена: Pay as You Go — от $11 за 5 часов; подписка — от $11 в месяц за 10 часов.
Cleanvoice выходит за рамки обычного denoise. Он умеет удалять фоновые шумы, дыхание, mouth sounds и длинные паузы, а также работать со словами-паразитами и запинками. Для подкаста это означает, что одна обработка затрагивает не только спектр звука, но и монтажную структуру: после автоматической очистки временная шкала действительно может стать короче.
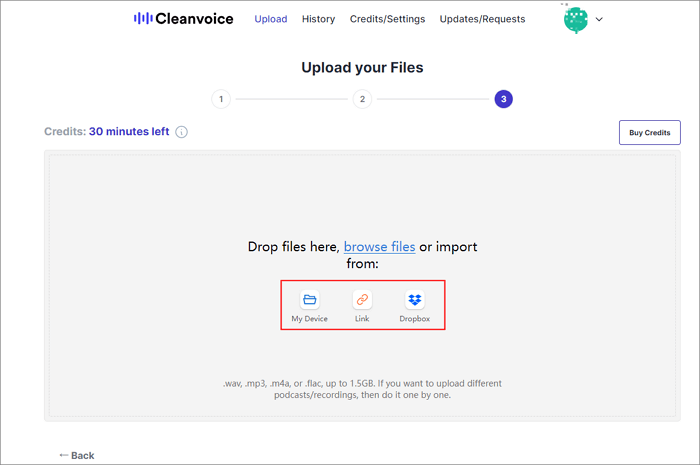
Сервис принимает WAV, MP3, OGG, FLAC, M4A, AIFF, AAC и видео MP4, MOV, WebM, AVI, MKV. Для интервью есть multitrack-режим: несколько дорожек одного разговора обрабатываются как единый выпуск с сохранением синхронизации. Это не то же самое, что batch: пакетный режим предназначен для нескольких независимых эпизодов, к которым применяется один шаблон.
Шумоподавление, trimming тишины, удаление дыхания, normalizing и Studio Sound работают на уровне сигнала и не зависят от языка. Для транскрипции поддерживаются десятки языков, включая русский. Удаление слов-паразитов языково-зависимо и требует особенно внимательной проверки: любое автоматическое вырезание речи способно сделать неестественную склейку, если междометие произнесено слитно с соседним словом.
Для рабочих материалов важна модель хранения: загруженные через API файлы автоматически удаляются через 7 дней. Сервис указывает размещение серверов и GPU в ЕС, соответствие GDPR и ISO 27001 и не использует пользовательские данные для обучения своих моделей.
Подходит для: регулярного подкаста, интервью, обучающих роликов и агентского производства, где дорого вручную чистить каждый вдох и паузу. Сервис особенно полезен после многодорожечной записи, но до финального музыкального сведения.
7. Audo Studio — минималистичная очистка шума и Auto Volume
Платформа: браузер; работает на Windows, macOS и Linux.
Язык интерфейса: английский.
Лимиты: Starter — 20 минут аудиоулучшения в месяц.
Цена: Starter — $0; Creator — $12 в месяц и 10 часов обработки в месяц.
Audo Studio рассчитан на ситуацию, когда не хочется разбираться в десятках модулей. После загрузки файла в рабочем окне доступны Auto Volume и Reduce Background Noise, причём для шумоподавления предусмотрена регулировка интенсивности. Текущий интерфейс также показывает Reduce Reverb как функцию, которая ещё не введена в основной рабочий процесс, поэтому рассчитывать на неё как на готовый инструмент не стоит.
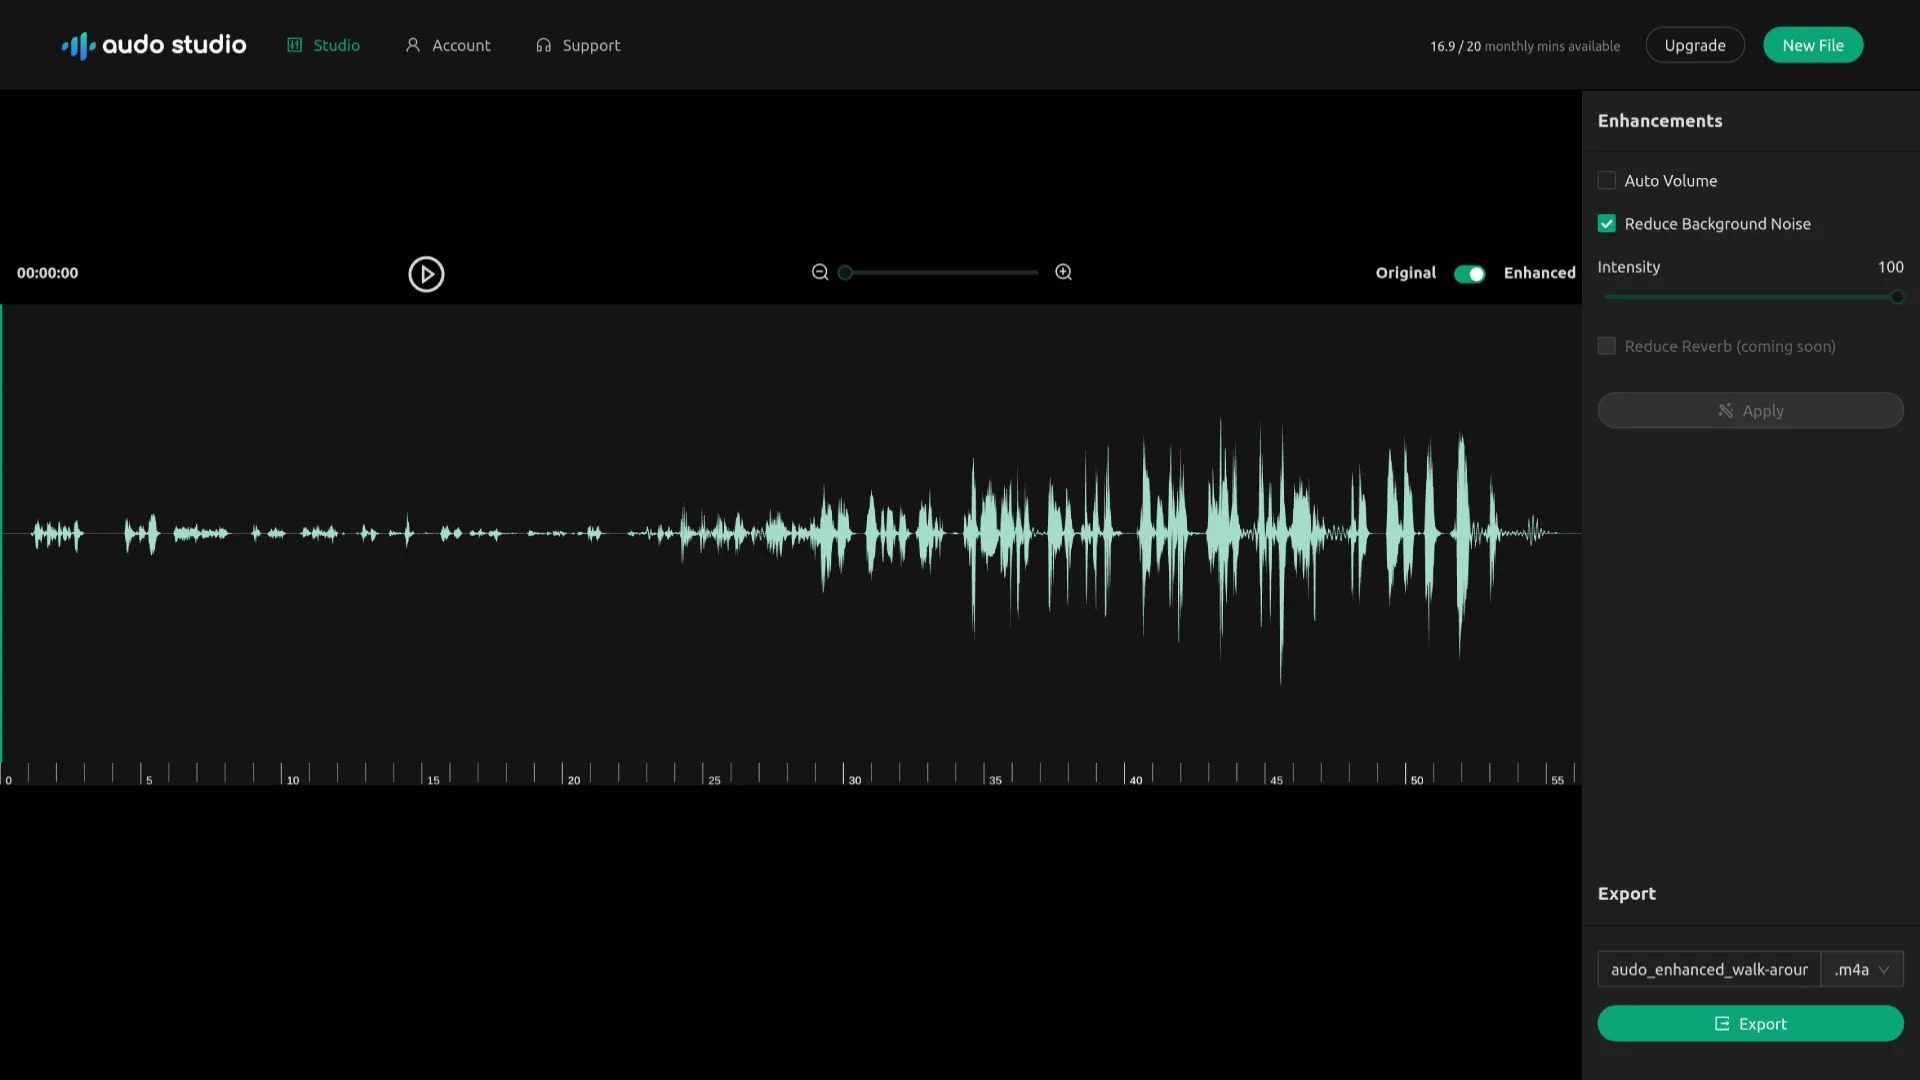
Практический сценарий простой: загрузить короткий фрагмент, включить Reduce Background Noise, выбрать умеренную интенсивность, применить обработку и переключить Original/Enhanced. Затем отдельно активировать Auto Volume, если уровень голоса гуляет между фразами. Такой порядок удобнее, чем сразу выкручивать все параметры: если тембр испортился, понятно, на каком шаге это произошло.
Файлы временно хранятся на серверах для обработки и удаляются в течение 48 часов после первоначальной обработки. Для длинных или чувствительных материалов это нужно учитывать заранее. Само приложение браузерное, поэтому установка на конкретную ОС не требуется.
Подходит для: короткого voice-over, голосовой заметки или дорожки для ролика, где основной дефект — постоянный бытовой шум и нестабильная громкость. Для сложной фоновой музыки, многодорожечного подкаста или детального монтажа понадобится другой инструмент.
8. Descript — Studio Sound внутри текстового монтажа
Платформа: Windows, macOS и веб-приложение в браузере.
Язык интерфейса: основной интерфейс — английский.
Лимиты: Free — 1 media hour в месяц и 100 AI credits; ИИ-инструменты доступны ограниченно.
Цена: Free — $0; Hobbyist — $24 в месяц или эквивалент $16 в месяц при годовой оплате; Creator — $35 или $24 соответственно.
Descript удобен, когда улучшение звука — только одна стадия монтажа. Studio Sound применяет ИИ к голосу, уменьшает фон и комнатные отражения, а затем запись продолжает жить в том же проекте: её можно редактировать по расшифровке, удалять слова-паразиты, перестраивать фразы и монтировать видео. Для подкаста и интервью это сокращает количество промежуточных экспортов между отдельным denoiser и монтажной программой.
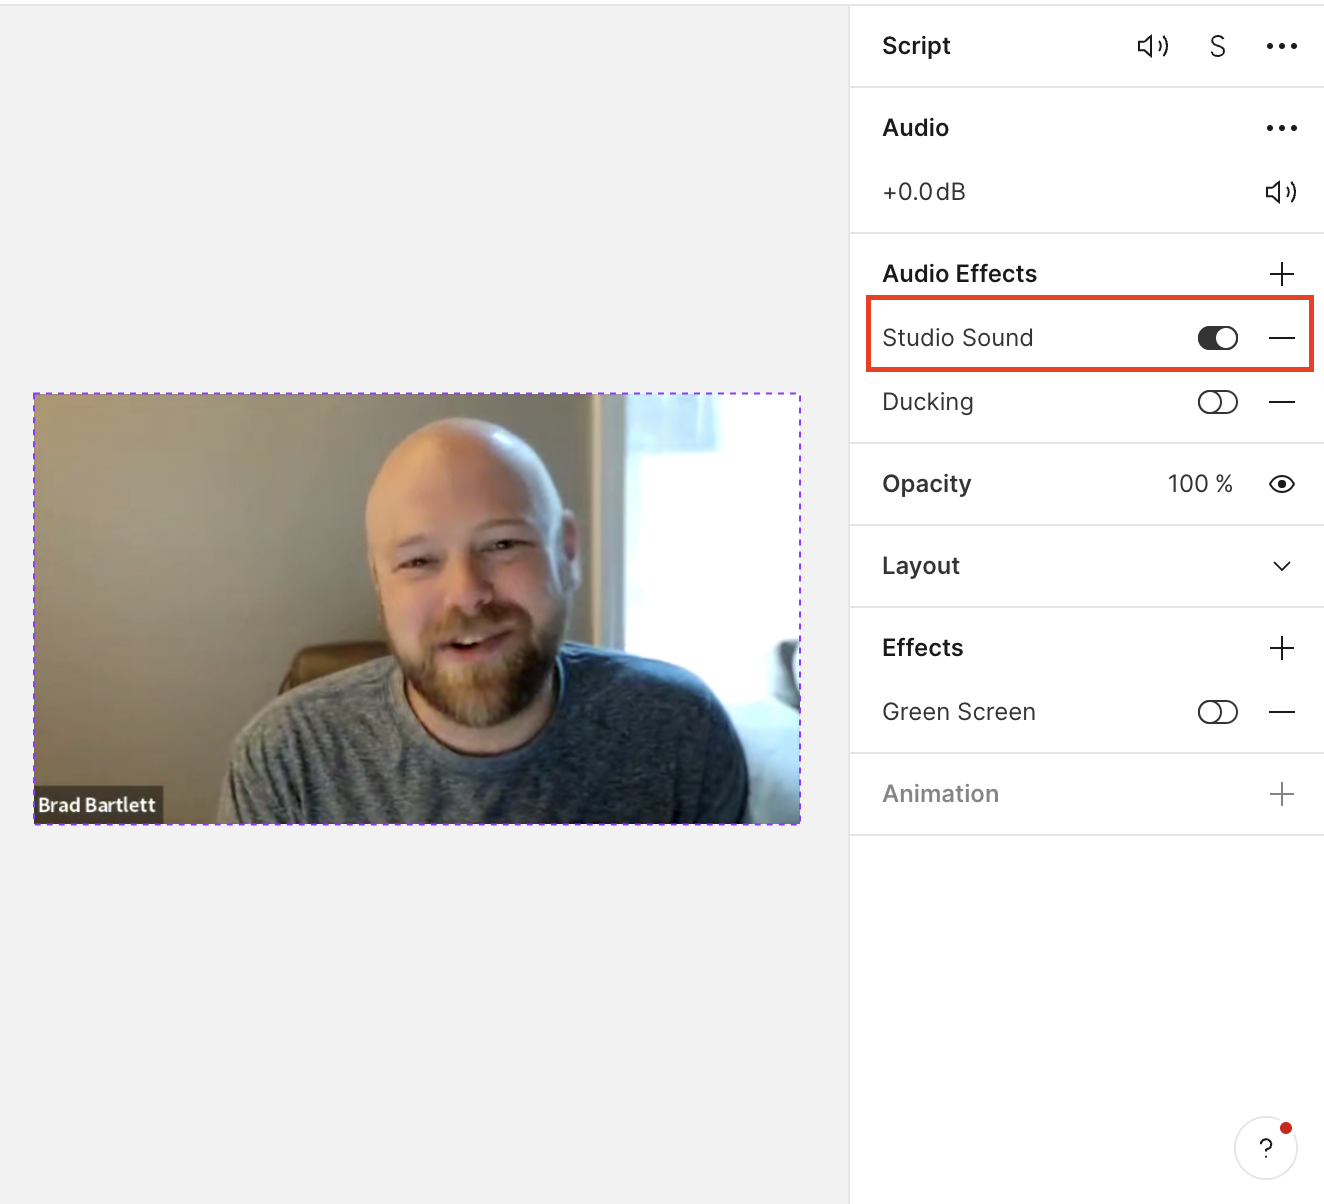
В обновлении июля 2026 года Studio Sound получил более быструю модель с меньшим количеством артефактов и лучшим сохранением индивидуальности голоса. Эффект рассчитан прежде всего на разговорный материал: интервью, подкасты, презентации и talking-head-видео. Сам Descript отдельно предупреждает, что этот инструмент не заменяет музыкальный мастеринг.
Важное преимущество для видеографа — единая временная шкала. После очистки не нужно экспортировать голос, возвращать его в монтаж и заново синхронизировать с изображением. При необходимости итоговое аудио можно выгрузить в MP3, WAV или M4A. Если проект уже собран в другой NLE, перенос имеет смысл только ради конкретной функции; в остальных случаях проще использовать встроенную обработку редактора или отдельный Enhance Speech.
Подходит для: автора видео или подкаста, которому нужен один проект для расшифровки, смыслового монтажа и очистки голоса. Если монтаж остаётся в классической программе, можно сравнить этот подход с CapCut Desktop и его инструментами монтажа, а нейросетевую реставрацию оставить отдельному сервису.
9. Async — бывший Podcastle с Magic Dust AI и многодорожечным редактором
Платформа: веб-сервис; для записи и части мобильных сценариев есть приложение iOS.
Язык интерфейса: основной рабочий интерфейс — английский.
Лимиты: Free — 10 AI credits на весь срок, 1 час загрузок в AI chat на весь срок и 2 ГБ облачного хранения.
Цена: Free — $0; платные уровни называются Essentials, Pro, Teams и Business.
В январе 2026 года Podcastle сменил название на Async. Аккаунты, проекты и привычные редакторские функции были перенесены в новую платформу, поэтому старое имя ещё встречается в инструкциях и обзорах. Для очистки голоса важен модуль Magic Dust AI: он объединяет шумоподавление, автоматическую эквализацию, vocal smoothing и выравнивание, а отдельные инструменты Noise Reduction, Auto Leveling и Silence Removal можно запускать самостоятельно.
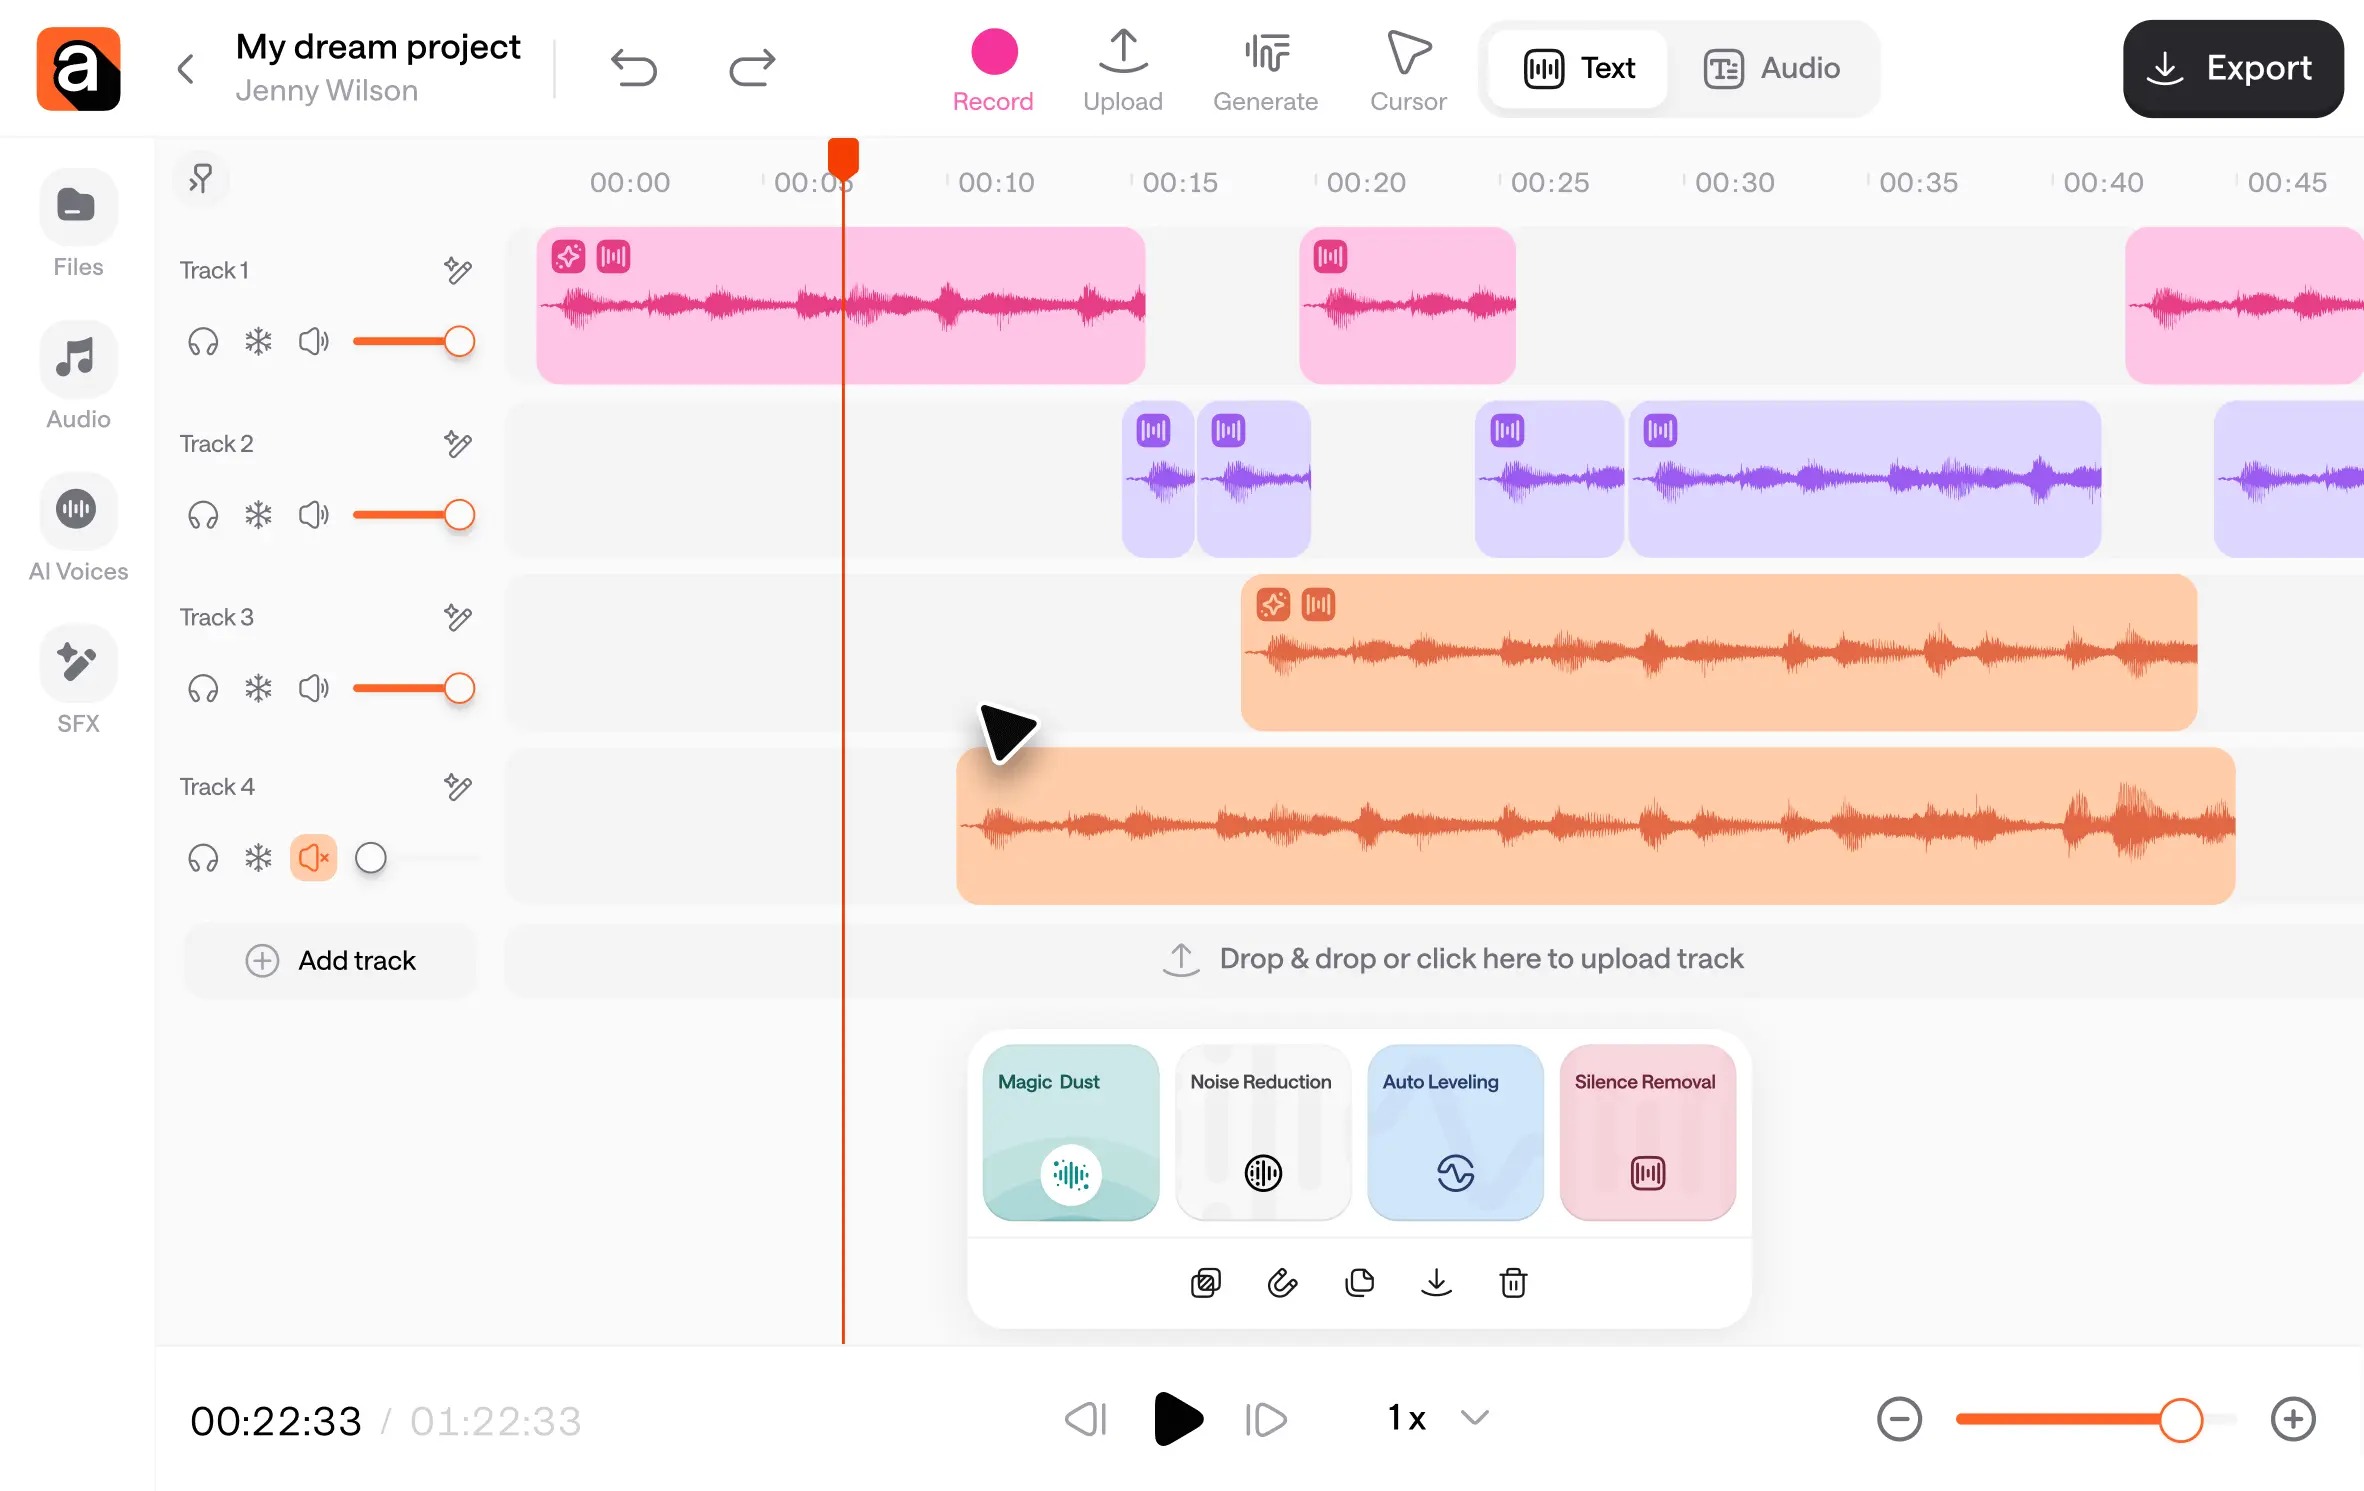
Magic Dust имеет регулировку интенсивности и рассчитан на речь. Справка отдельно не рекомендует применять его к музыке, сложным инструментальным композициям и звуковым эффектам. Ещё одно практическое ограничение: Magic Dust уже включает Noise Reduction, Auto Leveling и Silence Removal, поэтому повторное наложение этих же модулей поверх него способно ухудшить результат. Это редкий случай, когда «ещё один фильтр» действительно лишний.
Async остаётся удобным для подкаста, потому что связывает запись, многодорожечный монтаж, улучшение голоса и публикацию. В 2026 году платформа также получила более широкий набор генеративных функций и чат-ориентированный рабочий процесс, но для задачи очистки звука базовая логика прежняя: сначала оценить проблемный клип, затем выбрать отдельный Noise Reduction либо комплексный Magic Dust, после чего обязательно прослушать монтаж целиком.
Подходит для: автора подкаста или разговорного видео, которому нужен браузерный редактор с записью, несколькими дорожками и автоматической очисткой. Если требуется только восстановить один голосовой файл, Adobe Podcast или Audo Studio дадут более короткий маршрут.
Как выбрать нейросеть по характеру проблемы
Название дефекта важнее бренда сервиса. «Плохой звук» может означать как тихий микрофон, так и сильную реверберацию, музыку на фоне, клиппинг или несколько говорящих людей на одной дорожке. У каждого случая свой оптимальный порядок действий.
Постоянный шум: вентилятор, кондиционер, шипение
Для равномерного фона подойдут почти все сервисы из рейтинга. Audo Studio удобен для короткого файла и простой регулировки интенсивности. Auphonic полезнее, когда после denoise ещё нужно выровнять уровень и нормализовать loudness всего выпуска. В локальном редакторе стоит начинать с умеренного шумоподавления, потому что чрезмерное снижение шума быстрее всего создаёт «подводный» металлический оттенок.
Сильная комната и далёкий микрофон
Здесь задача сложнее: реверберация пересекается со спектром самого голоса. Adobe Enhance Speech v2 и Studio Sound в Descript рассчитаны на восстановление речи в таких условиях. После обработки нужно отдельно проверить окончания слов и тихие согласные. Если голос был очень далеко, модель способна сделать его субъективно ближе, но это не означает, что получившийся тембр полностью совпадает с исходным голосом.
Фоновая музыка или другой голос
Обычный шумовой фильтр плохо справляется с музыкальным сопровождением и человеческой речью, потому что это не стационарный шум. LALAL.AI Voice Cleaner специально разделяет голос и окружение. В Adobe Podcast Premium с 2026 года тоже есть отдельные слои speech, music и background. Для интервью на мероприятии такой контроль полезнее простого «удалить всё кроме речи» — часть естественной атмосферы можно оставить в миксе.
Разная громкость ведущего и гостя
Если оба голоса уже достаточно чистые, не стоит сразу применять сильную реставрацию. Auphonic Intelligent Leveler, Auto Volume в Audo Studio, Auto Leveling в Async или нормализация Cleanvoice решают именно проблему уровня. В многодорожечной записи лучше сохранять отдельные микрофоны как можно дольше и сводить их после очистки, а не заранее превращать всё в одну стереодорожку.
Онлайн-встреча или удалённое интервью
Krisp рациональнее включить до начала разговора. Он убирает шум в реальном времени и не требует сначала получить готовый файл. Но запись всё равно стоит делать с запасом качества и, по возможности, раздельно по участникам. Реальное время всегда ограничивает алгоритм по задержке, тогда как постобработка может потратить больше вычислений на сложный участок.
Подкаст с паузами, дыханием и словами-паразитами
Cleanvoice и Async полезнее одиночного denoiser, потому что затрагивают монтаж. В Cleanvoice есть удаление дыхания, mouth sounds, пауз и слов-паразитов; в Async — Magic Dust, Silence Removal и Auto Leveling. Здесь главная проверка не спектральная, а редакторская: после автоматических склеек речь должна сохранять естественный ритм, не терять смысл и не звучать так, будто слова «прилипли» друг к другу.
Как проверить нейросеть за 15 минут
Сравнивать сервисы на разных файлах бессмысленно. Подготовьте один фрагмент длиной 30–60 секунд, в котором есть сразу несколько сложных мест: тихая фраза, громкая фраза, шум без речи, вдох, сибилянты «с/ш», взрывные «п/б», короткая пауза и участок с фоном. Сохраните копию исходника и прогоните один и тот же фрагмент через два-три кандидата.
- Сделайте эталонное прослушивание. Отметьте, что именно мешает: гул, эхо, музыка, скачки громкости, посторонняя речь. Не пытайтесь лечить дефект, которого нет.
- Запустите умеренный режим. Если есть ползунок интенсивности, начните не с максимума. Цель первого прохода — сохранить голос, а не добиться абсолютной тишины между словами.
- Сравняйте громкость. Улучшенная дорожка часто воспринимается «качественнее» просто потому, что стала громче. Перед сравнением выровняйте субъективный уровень Original и Enhanced.
- Прослушайте проблемные согласные. Наушники хорошо выявляют металлический хвост после «с», обрезанные окончания, синтетический призвук в шёпоте и дрожание тембра.
- Проверьте паузы. Абсолютно мёртвая тишина между фразами может звучать неестественно. В видео также заметны резкие переключения фоновой атмосферы.
- Экспортируйте один мастер. Для дальнейшего монтажа предпочтителен WAV или другой доступный несжатый вариант. Не стоит многократно перегонять промежуточный звук через MP3/AAC.
Если два сервиса звучат одинаково на спокойной фразе, слушайте сложные переходы: начало слова после шума, перекрытие голоса музыкой, смех, кашель, хлопок и короткий вдох. Именно такие моменты показывают, насколько алгоритм устойчив, а не насколько красиво звучит демонстрационный пример.
Что сохранять на каждом этапе
| Этап | Что хранить | Зачем |
|---|---|---|
| Сразу после записи | Исходный файл без обработки | Можно вернуться к оригиналу, если ИИ изменил голос или вырезал полезный фрагмент |
| После нейросети | Отдельный очищенный мастер | Удобно сравнивать разные алгоритмы и не повторять облачную обработку |
| После монтажа речи | Проект или редактируемую временную шкалу | Автоматические склейки можно исправить без нового расчёта всего выпуска |
| Перед публикацией | Финальный WAV/мастер и публикационный файл | Мастер остаётся для будущего монтажа, а MP3/AAC используется только для доставки |
Такой подход особенно важен для сервисов с ограниченными минутами. Если после каждой мелкой правки заново отправлять часовой выпуск в облако, лимит расходуется на повторную обработку тех же фрагментов. Проще сначала выбрать настройки на коротком отрезке, затем обработать полный файл один раз и продолжить монтаж уже с сохранённой копией.
Типичные артефакты ИИ-очистки и как их распознать
Голос стал металлическим или «под водой»
Обычно это результат слишком агрессивного отделения шума от речи. Уменьшите интенсивность, верните часть фона или попробуйте модель, которая сохраняет больше исходной акустики. В Adobe Podcast Premium для этого полезен раздельный контроль Speech и Background; в LALAL.AI — Noise Canceling Level. Если проблема появляется только на одном коротком месте, обработайте его отдельно, а не усиливайте эффект на всём файле.
Пропали окончания слов и тихие согласные
Алгоритм мог принять слабый речевой компонент за шум. Такое чаще заметно на далёкой записи, шёпоте и фразах после паузы. Сравните несколько слов с исходником на нормальной скорости и на коротком цикле. Если смысл меняется, лучше оставить немного шума, чем публиковать более «чистую», но неверную речь.
Фон начинает «дышать» между фразами
При неудачной работе шумоподавления уровень помещения меняется вместе с голосом: во время речи фон приглушается, в паузах возвращается. В подкасте это слышно как пульсация. Лечится уменьшением силы эффекта, сохранением постоянного room tone или более аккуратным сведением фонового слоя.
После автоматического удаления пауз речь стала нервной
Silence Removal и похожие функции экономят монтажное время, но не понимают драматургию каждого разговора. Пауза перед ответом, вдох или короткая тишина после важной фразы могут быть содержательной частью речи. Верните часть интервала на временной шкале или уменьшите агрессивность удаления.
Музыка превратилась в шорох
Инструмент, обученный на речи, пытается интерпретировать музыку как нежелательный фон. Не применяйте Studio Sound, Magic Dust или похожие речевые улучшатели ко всему мастер-миксу. По возможности отделяйте голосовую дорожку от музыки до обработки, а затем собирайте баланс заново.
После улучшения появился клиппинг
Некоторые цепочки одновременно поднимают голос и нормализуют уровень. Если исходник уже близок к 0 dBFS, дополнительное усиление способно создать перегруз. Проверяйте пики после каждого автоматического этапа и не путайте «громче» с «чище». Auphonic позволяет сразу работать с заданными loudness и true-peak параметрами, что удобно для длинных выпусков.
Чек-лист перед экспортом
- исходный файл сохранён отдельно и не перезаписан;
- Original и Enhanced сравнивались при сопоставимой громкости;
- прослушаны самые тихие и самые громкие участки, а не только середина записи;
- согласные, вдохи, смех и перекрывающиеся голоса не получили заметных цифровых артефактов;
- автоматическое удаление пауз и слов не изменило смысл и темп речи;
- музыка и атмосферные звуки не проходили через речевой enhancer без необходимости;
- для дальнейшего монтажа сохранён мастер без лишнего повторного сжатия;
- финальная громкость проверена уже после всех склеек, музыки и заставок;
- если используется облачный сервис, правила проекта допускают загрузку этой записи на внешнюю платформу.
Для ролика последняя проверка должна выполняться вместе с изображением. Даже идеальная отдельная дорожка может оказаться неудачной в монтаже, если нейросеть изменила атаку слова и губы перестали точно совпадать со звуком. При заметном рассинхроне лучше вернуть исходный фрагмент и сделать более мягкую обработку.
Частые вопросы
Можно ли нейросетью восстановить перегруженный звук?
Частично — да, но результат нельзя считать достоверным восстановлением исходной формы волны. Если микрофон или рекордер жёстко обрезал пики, часть информации физически потеряна. Некоторые алгоритмы сглаживают клиппинг и реконструируют правдоподобный контур речи, но на голосе могут появиться новые гармоники и измениться атака согласных. Для важного интервью лучше использовать реконструкцию как спасательный вариант и хранить оригинал.
Повысится ли качество, если перед загрузкой перевести MP3 в WAV?
Нет: конвертация уже сжатого MP3 в WAV не возвращает удалённые при кодировании детали. WAV полезен после обработки как рабочий мастер, чтобы не добавлять ещё одно поколение потерь. Если исходная запись изначально есть в WAV, FLAC или другом несжатом/без потерь формате, именно её стоит отправлять на обработку.
Нужно ли сначала нормализовать громкость, а потом удалять шум?
Не всегда. Сильное усиление до denoise поднимает вместе с речью и фон. В автоматических системах вроде Auphonic порядок уже заложен в цепочку. При ручной работе разумнее сначала убрать критические дефекты умеренно, затем выровнять динамику и только в конце устанавливать финальную громкость.
Что выбрать для конфиденциального разговора?
Нужно смотреть не только на название функции, но и на место обработки. Krisp выполняет именно noise cancellation локально на устройстве, хотя его функции записи и Meeting Assistant связаны с отдельными облачными данными. LALAL.AI Voice Cleaner, Adobe Podcast, Audo Studio и Cleanvoice предполагают загрузку файла в сервис. Для закрытого материала правила организации могут полностью запрещать такую передачу, даже если платформа публикует подробную политику безопасности.
Какой сервис удобнее для звука с камеры?
Для talking-head и интервью с камеры проще всего начать с Adobe Podcast Enhance Speech: платный режим принимает видео и позволяет регулировать речь, музыку и фон. Descript тоже удобен, когда видео сразу монтируется по расшифровке. Если исходный ролик уже собран в NLE и нужна только финальная дорожка, можно извлечь WAV, обработать его отдельно и вернуть в монтаж без лишней перекодировки изображения.
Подходит ли ИИ-очистка для музыки?
Речевые модели — не универсальный мастеринг. LALAL.AI предлагает отдельные режимы разделения вокала и инструментов, но Studio Sound, Enhance Speech, Magic Dust и Audo Studio в первую очередь рассчитаны на голос. Для музыкального микса важны баланс инструментов, динамика, панорама и сохранение транзиентов; агрессивное речевое шумоподавление легко разрушает эти элементы.
Что выбрать в итоге
Для одного шумного интервью или закадровой речи первым стоит сравнить Adobe Podcast Enhance Speech и LALAL.AI Voice Cleaner: первый сильнее ориентирован на восстановление разговорного голоса и комнатной акустики, второй — на отделение голоса от меняющегося фона и музыки. Audo Studio проще по интерфейсу и подходит для короткой однотипной очистки.
Для регулярного подкаста важнее весь производственный маршрут. Auphonic закрывает шум, выравнивание спикеров и финальную loudness-нормализацию; Cleanvoice дополнительно автоматизирует паузы, дыхание и речевой мусор; Descript и Async объединяют улучшение со смысловым и многодорожечным монтажом. Krisp стоит выбирать не вместо этих сервисов, а раньше — на этапе онлайн-разговора, чтобы меньше проблем попало в запись.
АудиоМАСТЕР остаётся полезной альтернативой, когда нужен обычный Windows-редактор с точным выделением фрагментов, монтажом и ручной обработкой. Его не следует путать со специализированной нейросетью восстановления речи, зато он даёт понятный контроль над тем, какие изменения вносятся в дорожку. Независимо от выбранного инструмента, качественный финал определяется не силой кнопки Enhance, а сохранностью исходника, умеренной обработкой и обязательным прослушиванием самых сложных фрагментов перед публикацией.