Когда для ролика, обучающего курса, интерфейса или подкаста нужен голос, необязательно записывать диктора для каждой новой версии текста. Система синтеза речи преобразует письменный текст в звуковой сигнал: определяет, как прочитать числа и сокращения, выбирает произношение слов, строит интонацию и формирует аудио. Но кнопка «Синтезировать» решает только часть задачи. Чтобы голос звучал понятно и не мешал видеоряду, текст приходится готовить для восприятия на слух, спорные слова — проверять, а готовую дорожку — прослушивать и при необходимости редактировать.
Ниже разобрано, как устроен TTS, чем современный нейросетевой синтез отличается от прежних методов, как подготовить русский текст и как получить контролируемый результат четырьмя практическими способами. Отдельное внимание уделено работе с озвучкой для видео: паузам, длине фраз, ударениям, стыкам после монтажа, уровню сигнала и проверке финального файла.
- Что такое синтез речи и чем он отличается от похожих технологий
- Как TTS превращает текст в голос
- 1. Нормализация текста
- 2. Лингвистический разбор и произношение
- 3. Просодия: паузы, темп и интонация
- 4. Акустическое представление и формирование звука
- Как развивались методы синтеза речи
- Формантный и параметрический синтез
- Конкатенативный синтез и unit selection
- Статистические и нейросетевые модели
- Подготовка текста: что сделать до нажатия кнопки синтеза
- Пишите фразы для слуха, а не для страницы
- Раскрывайте числа и обозначения, где смысл важнее компактности
- Отмечайте ударения только там, где они действительно нужны
- Ставьте паузы по смыслу
- Делите длинный материал на контролируемые фрагменты
- Мини-чек-лист текста перед синтезом
- Практика: четыре способа получить и подготовить синтезированную речь
- 1. АудиоМАСТЕР: привести готовую TTS-дорожку к монтажу
- Как обработать синтезированную дорожку
- 2. Yandex SpeechKit: синтез в AI Studio
- Как синтезировать тестовый фрагмент
- 3. SaluteSpeech App: вариант для уже подключённых проектов
- Как получить реплику в существующем проекте
- 4. Android: системный синтез речи для чтения текста на устройстве
- Как проверить TTS на смартфоне
- Как проверить качество синтезированной речи
- Сначала проверьте содержание
- Затем слушайте ударения и связность
- Проверьте паузы относительно изображения
- Отдельно оцените технический файл
- Типичные артефакты: причина и безопасное исправление
- Неверное ударение
- Странное чтение цифр, дат и сокращений
- Слишком ровная интонация
- Резкий стык после замены одного слова
- Щелчок после ручной обрезки
- Сценарии использования синтеза речи
- Озвучка видео и скринкастов
- Обучающие материалы и инструкции
- Подкасты и длинная повествовательная речь
- Доступность интерфейсов
- Автоматические уведомления и голосовые интерфейсы
- Форматы и монтаж: как не испортить готовый голос
- Матрица сохранности результата
- Что важно знать о голосовом клонировании, правах и доверии аудитории
- Как выбрать подходящий маршрут
- Чек-лист перед финальным экспортом
- Вопросы, которые возникают при первой работе с TTS
- Можно ли сделать хороший синтез без специальной разметки?
- Почему короткая тестовая фраза звучит хорошо, а длинный абзац — монотонно?
- Нужно ли обрабатывать TTS после генерации?
- Почему нельзя просто ускорить слишком длинную реплику?
- Что хранить после завершения проекта?
- Можно ли использовать один голос для всех типов контента?
- Итог
- Предложить модель для рейтинга
Что такое синтез речи и чем он отличается от похожих технологий
Синтез речи — это автоматическое формирование речевого звукового сигнала по входным данным. В повседневных программах под этим обычно понимают TTS, от английского text-to-speech: на вход подают текст, на выходе получают звучащую речь. Такой механизм используется в экранных дикторах, голосовых интерфейсах, навигации, автоматической озвучке роликов, телефонных сценариях и образовательных материалах.
У синтеза есть две самостоятельные задачи. Первая — разбор текста: система должна понять, что именно произносить. Вторая — акустическое формирование речи: нужно решить, как это произнести и превратить последовательность звуков в аудиосигнал. Ошибка на первом этапе даёт неправильное слово, ударение или чтение числа. Ошибка на втором чаще слышна как неестественный тембр, резкая смена интонации, странная длительность фонем или артефакт на стыке.
Синтез речи не следует путать с распознаванием речи. Распознавание выполняет обратное преобразование: принимает звук с человеческой речью и превращает его в текст. Ещё одна отдельная технология — преобразование одного голоса в другой, когда входом служит уже произнесённая фраза. Клонирование голоса тоже не тождественно обычному TTS: его цель — воспроизвести особенности конкретного диктора, а не просто озвучить текст выбранным штатным голосом.
| Технология | Что поступает на вход | Что получается | Типичный сценарий |
|---|---|---|---|
| TTS, синтез речи | Текст | Звуковая речь | Озвучка ролика, интерфейса, инструкции |
| Распознавание речи | Запись голоса | Текст | Расшифровка интервью, субтитры |
| Преобразование голоса | Уже произнесённая речь | Речь с изменёнными голосовыми характеристиками | Творческая обработка или локализация |
| Клонирование голоса | Образцы голоса и текст либо речевой материал | Речь, имитирующая особенности заданного голоса | Персонализированная озвучка при наличии прав на голос |
Для оценки TTS полезно разделять разборчивость и естественность. Разборчивый голос позволяет без догадок понять слова, даты и имена. Естественный голос дополнительно передаёт уместный ритм, паузы, логические акценты и мелодику фразы. Для служебного сообщения иногда достаточно высокой разборчивости; для длинного видео или аудиокурса монотонность и неправильные акценты быстро утомляют, даже когда каждое слово формально понятно.
Как TTS превращает текст в голос
Современная реализация может объединять несколько стадий внутри одной нейросетевой модели, но логика задачи остаётся той же: текст необходимо нормализовать, сопоставить с произношением, задать длительности и интонацию, а затем сформировать звуковую волну. Понимание этой цепочки помогает исправлять ошибки не наугад, а на том уровне, где они возникают.
1. Нормализация текста
Письменный текст содержит элементы, которые нельзя прочитать буквально по символам: даты, денежные суммы, номера, сокращения, единицы измерения, знаки процента, адреса и буквенно-цифровые обозначения. Нормализация преобразует их в форму, пригодную для произнесения. Например, «19.09.2026» и «19 сентября 2026 года» визуально передают близкую информацию, но второй вариант гораздо однозначнее для озвучки.
Особенно внимательно стоит готовить фрагменты, где запись зависит от контекста. «5 м» может означать пять метров, а одиночная буква «м» — быть частью обозначения или имени переменной. «1,5» в русскоязычном тексте должно читаться как десятичное число, но смысл фразы определяет падеж следующего слова. Поэтому сценарий для синтеза лучше писать не так, как его удобнее сканировать глазами, а так, как его должны услышать.
2. Лингвистический разбор и произношение
После нормализации система определяет слова, их формы и произношение. Для русского языка важны ударения и омографы — слова с одинаковым написанием и разным звучанием. Классический пример — «замок»: ударение меняет значение. Контекст помогает модели выбрать вариант, но критичные названия брендов, фамилии, географические названия и профессиональные термины всё равно нужно прослушивать отдельно.
На этом этапе буквенная запись связывается с фонемами — минимальными звуковыми единицами языка. В нейросетевых системах внутреннее представление не обязано буквально повторять традиционный фонетический словарь, однако практический смысл остаётся прежним: движку необходимо определить последовательность звуков, соответствующую тексту.
3. Просодия: паузы, темп и интонация
Просодия описывает надсегментные свойства речи: ритм, длительность, ударения, паузы, мелодику и интонационный рисунок. Одна и та же последовательность слов может звучать как утверждение, вопрос, перечисление или эмоциональный акцент. Пунктуация даёт системе часть подсказок, а в некоторых TTS-инструментах дополнительно доступны управляющие теги, скорость, роль голоса, высота тона и явные паузы.
Для видеомонтажа просодия влияет ещё и на тайминг. Ускорение голоса сокращает дорожку, но не исправляет неудачную структуру фразы. Если дикторский текст не помещается в сцену, сначала полезнее убрать повтор, разбить длинное предложение или заменить тяжёлый оборот коротким, а уже затем корректировать скорость синтеза.
4. Акустическое представление и формирование звука
Следующий этап переводит лингвистическую структуру в акустические параметры: система моделирует изменение спектра, высоты основного тона, длительностей и других характеристик во времени. Затем вокодер или другой модуль генерации формирует итоговую звуковую волну. В нейросетевых архитектурах граница между этими стадиями может быть скрыта внутри модели, поэтому пользователь видит один процесс — от текста до готового фрагмента аудио.
С точки зрения автора контента важен не внутренний формат модели, а воспроизводимый контроль результата. После каждой существенной правки текста нужно заново прослушать проблемный участок. Незаметная на экране замена тире, точки или порядка слов способна изменить длительность паузы и логический акцент.
Как развивались методы синтеза речи
История TTS прошла несколько технологических этапов. Ранние подходы стремились воспроизвести работу речевого тракта или собрать речь из формальных акустических параметров. Позже широко использовалась конкатенация заранее записанных единиц. Статистические модели сделали управление параметрами гибче, а нейросетевые методы заметно улучшили связность и естественность длинных фраз.
Формантный и параметрический синтез
Формантный синтез описывает речь через параметры, связанные с резонансами речевого тракта. Его сильная сторона — компактность и возможность управлять параметрами без огромной базы записей. Ограничение хорошо слышно на сложной связной речи: такой голос часто воспринимается как механический, особенно по сравнению с современными нейросетевыми системами.
Параметрические методы шире: вместо хранения целых фрагментов записи они моделируют акустические характеристики речи и затем восстанавливают сигнал. Это даёт управляемость, но качество зависит от того, насколько точно модель и вокодер сохраняют детали человеческого голоса.
Конкатенативный синтез и unit selection
В конкатенативных системах речь собирается из заранее записанных единиц: фонем, дифонов, слогов или более длинных фрагментов. Чем удачнее найден подходящий кусок и чем меньше заметен стык, тем естественнее звучит результат. Метод способен давать убедительный тембр, потому что использует реальную запись диктора, но требует большой подготовленной базы.
Проблема проявляется на переходах и непривычных сочетаниях. Если нужного контекста нет в базе, система вынуждена выбирать менее подходящие куски, а склейка становится слышимой. Кроме того, существенная смена стиля, эмоции или темпа требует материала, записанного с такими же характеристиками.
Статистические и нейросетевые модели
Статистические методы научились предсказывать акустические характеристики по языковому контексту, а нейросетевые модели сделали такое предсказание точнее. Современный TTS способен учитывать контекст длиннее отдельного слова, формировать плавную интонацию и синтезировать сигнал без хранения готовой фразы в базе.
Нейросетевой подход не отменяет редакторскую подготовку текста. Модель может звучать естественно и при этом неверно прочитать редкую фамилию, цифровое обозначение объектива, аббревиатуру или намеренно необычное название продукта. Чем выше требования к содержанию, тем важнее контроль произношения, а не только субъективное впечатление от тембра.
Подготовка текста: что сделать до нажатия кнопки синтеза
Большая часть проблем TTS устраняется до генерации аудио. Исходный сценарий следует адаптировать для слухового восприятия: убрать конструкции, которые понятны только при чтении глазами, раскрыть неоднозначные сокращения и заранее отметить места, где требуется пауза. Такой текст проще синтезировать, монтировать и проверять.
Пишите фразы для слуха, а не для страницы
В кадре зритель не может вернуться глазами на начало длинного предложения, пока голос продолжает говорить. Для озвучки удобнее одна мысль на фразу, прямой порядок слов и короткие перечисления. Тяжёлое предложение из нескольких придаточных лучше разбить на два или три, особенно когда одновременно на экране меняются планы, подписи или графика.
Полезная проверка — прочитать сценарий вслух обычным темпом. Места, где человек вынужден добирать дыхание, возвращаться к началу или менять порядок слов, почти всегда требуют редактуры и перед TTS. Это не попытка подстроиться под машину: такой сценарий обычно легче воспринимает и живой слушатель.
Раскрывайте числа и обозначения, где смысл важнее компактности
Даты, дроби, диапазоны, проценты, артикулы и технические индексы следует приводить к форме, которая однозначно произносится. В ролике о камере «1/125» может означать выдержку «одна сто двадцать пятая секунды», а буквенно-цифровая модель устройства должна звучать так, как её принято произносить в отрасли. Если движок читает обозначение не так, как требуется, надёжнее переписать фразу фонетически понятнее или применить средства управления произношением, доступные в конкретном TTS.
Отмечайте ударения только там, где они действительно нужны
Необязательно вручную размечать каждое слово. Сначала синтезируйте небольшой тестовый отрывок, затем поправьте конкретные ошибки: фамилии, названия городов, омографы, профессиональные термины. В SpeechKit Playground для этого предусмотрены инструменты ударения и фонетических подсказок; в других системах могут использоваться собственная разметка или SSML.
Ставьте паузы по смыслу
Запятая, тире, двоеточие и точка влияют на ритм, но не всегда дают точную длительность. Явная пауза полезна перед новым смысловым блоком, после заголовка, между инструктивными шагами и перед числом, которое зрителю нужно успеть прочитать на экране. Слишком частая разметка делает голос рубленым, поэтому сначала стоит настроить текст и пунктуацию, а теги использовать для мест, где обычная пунктуация не даёт нужного результата.
Делите длинный материал на контролируемые фрагменты
Для ролика удобнее синтезировать не часовую дорожку одним файлом, а логические блоки: вступление, отдельные сцены, пункты инструкции, заключение. Тогда правка одного слова не заставляет пересобирать весь проект, а на монтажной шкале проще заменить нужный фрагмент. Границы лучше ставить в естественных паузах, а не посреди предложения.
Имена файлов тоже должны помогать монтажу: например, «01_intro», «02_import», «03_export». Нумерация сохраняет порядок даже после передачи проекта другому редактору. Отдельно оставьте текстовый сценарий с теми же номерами — так проще найти источник фразы, если произношение нужно исправить.
Мини-чек-лист текста перед синтезом
- каждое предложение удобно воспринимать на слух без возврата к началу;
- даты, единицы измерения и сложные числа записаны однозначно;
- редкие имена и названия вынесены в короткий тестовый фрагмент;
- паузы совпадают с логикой фразы и сменой визуальных сцен;
- длинные перечисления разбиты на части;
- аббревиатуры читаются так, как требуется в готовой публикации;
- в тексте нет лишних скобок, ссылок и визуальных обозначений, которые не нужно произносить;
- сценарий разбит на фрагменты, которые можно заменить независимо друг от друга.
Практика: четыре способа получить и подготовить синтезированную речь
Инструменты ниже решают разные части процесса. АудиоМАСТЕР нужен после генерации голоса — для локального редактирования готового файла. SpeechKit выполняет сам синтез в облаке. SaluteSpeech остаётся рабочим вариантом для уже подключённых проектов, но с 15 июля 2026 года подключение новых клиентов к сервису недоступно. Системный TTS Android подходит для чтения текста на устройстве и быстрой проверки того, как фраза звучит в экранном интерфейсе.
1. АудиоМАСТЕР: привести готовую TTS-дорожку к монтажу
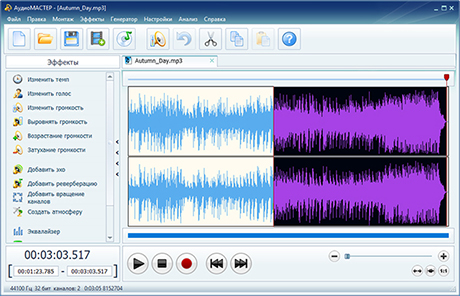
АудиоМАСТЕР не является движком text-to-speech. Он не превращает введённый текст в синтезированный голос. Его место в первом маршруте — постобработка: сначала голос создаётся в TTS-сервисе, затем готовый WAV, MP3 или другой поддерживаемый аудиофайл открывается в редакторе, где можно убрать лишние края, выровнять громкость, скорректировать тембр и сохранить результат для монтажа.
Программа работает в Windows 11, 10, 8, 7 и XP. Среди основных операций есть запись с микрофона, обрезка и объединение аудио, эффекты, извлечение звука из видео и экспорт в распространённые аудиоформаты. Для синтезированной речи особенно полезны обрезка, регулировка громкости и эквалайзер: эти действия не меняют слова, но позволяют подготовить дорожку к соседству с музыкой и исходным звуком ролика.
Как обработать синтезированную дорожку
- Сохраните исходник отдельно. Не перезаписывайте единственную копию синтеза. Оригинал нужен для отката, если после обработки появится перегрузка, слишком сильная коррекция тембра или неудачный стык.
- Откройте TTS-файл в АудиоМАСТЕР. На стартовом экране доступны операции открытия аудио, извлечения звука из видео и записи голоса. Для готового синтеза нужен обычный импорт аудиофайла.
- Прослушайте начало, конец и сложные слова. До обработки отметьте речевые ошибки. Неверное ударение или пропущенное слово нельзя исправить эквалайзером — такой участок нужно пересинтезировать в исходном TTS.
- Уберите лишнюю тишину. По волновой форме выделите ненужный участок до первой фразы или после последней и выполните обрезку. Оставляйте короткий запас тишины, если дорожка будет стыковаться с соседними репликами.
- Проверьте громкость. В редакторе есть команда «Изменить громкость» и отдельное выравнивание громкости. Корректируйте уровень только после прослушивания: слишком большой подъём способен привести к перегрузке пиков.
- При необходимости используйте эквалайзер. Он полезен для умеренной тональной коррекции, например когда синтетический голос слишком резко выделяется рядом с другой речью. Сильная коррекция ухудшает естественность и усиливает искусственные призвуки.
- Сохраните отдельный мастер. Для экспорта используется «Файл» → «Сохранить как». В окне сохранения выбираются расширение, частота дискретизации, режим каналов и битрейт. Для дальнейшего монтажа удобен несжатый или слабо обработанный мастер; финальный сжатый файл можно делать после сведения.
Как проверить результат. Прослушайте не только обработанный файл отдельно, но и его участок в проекте с музыкой и исходным звуком. Речь должна оставаться разборчивой без постоянного изменения общей громкости. На стыках не должно быть щелчков, внезапно обрезанных согласных и скачков фонового уровня.
Типичная ошибка. Попытка исправить неверное произношение аудиоредактором. Если TTS неправильно поставил ударение или прочитал число, вернитесь к тексту, исправьте разметку и пересинтезируйте конкретную реплику. Аудиоредактор нужен после того, как содержание уже произнесено правильно.
Если исходный материал сначала требуется записать живым голосом, полезна отдельная инструкция по записи речи на компьютер. Для преобразования медиаматериалов между контейнерами и форматами пригодится разбор конвертации аудио и видео.
2. Yandex SpeechKit: синтез в AI Studio
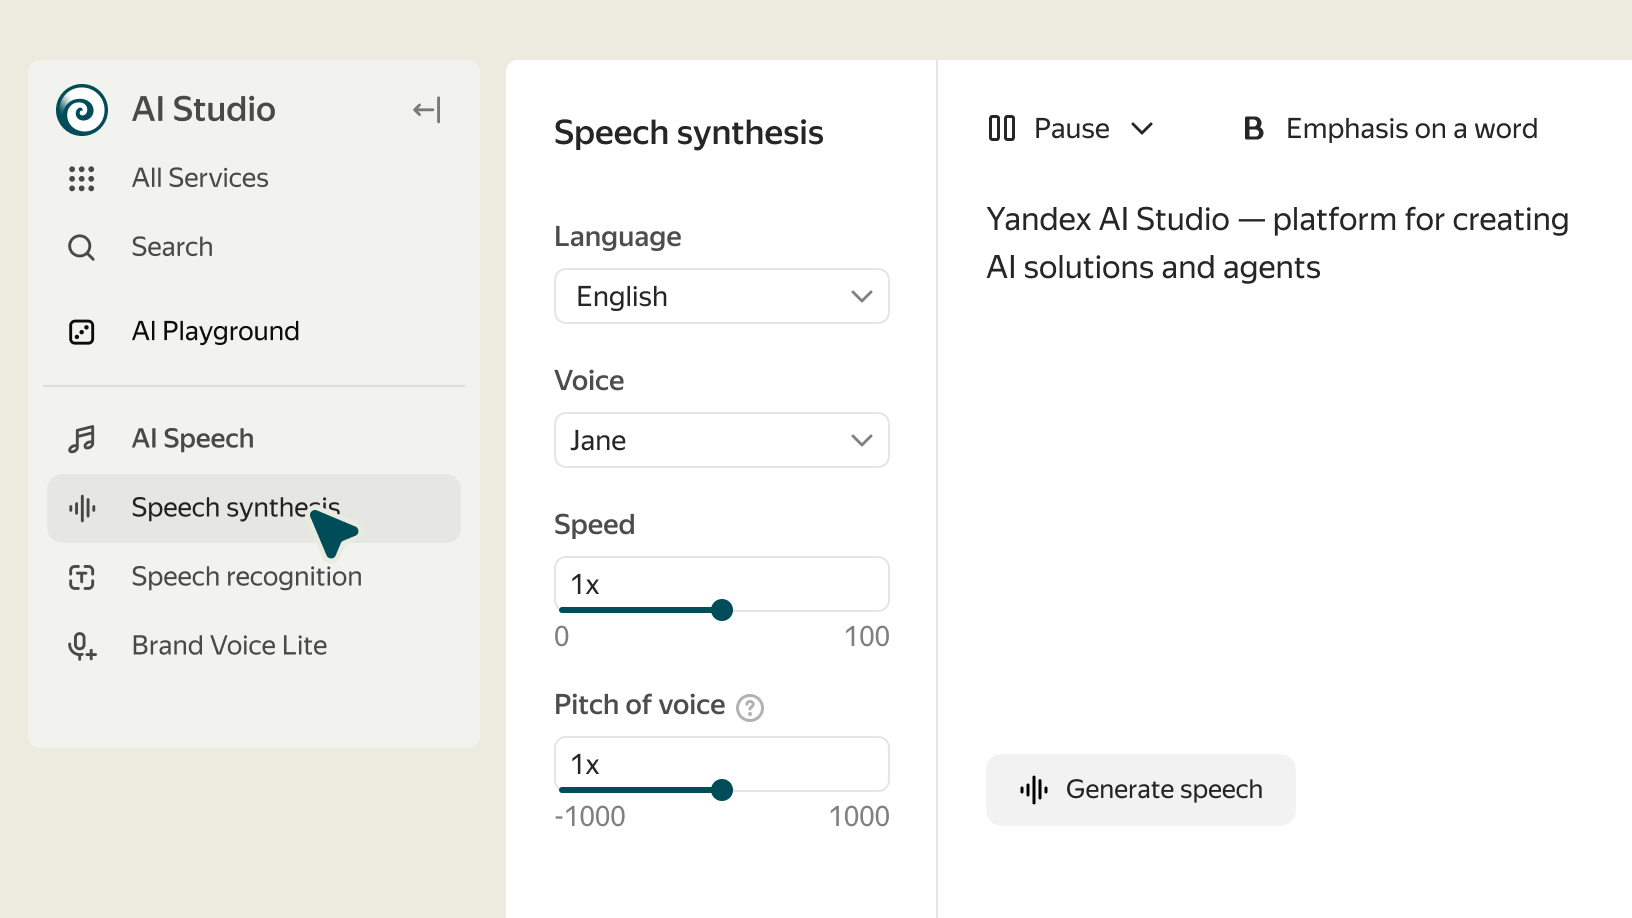
SpeechKit — облачная платформа распознавания и синтеза речи. Для ручной работы без программирования используется интерфейс Yandex AI Studio: в разделе AI Speech доступна вкладка «Синтез речи». Здесь можно ввести текст, выбрать язык, голос и амплуа, настроить скорость, высоту тона и формат, а также использовать средства управления ударениями, паузами и произношением.
Playground подходит для проверки сценария перед интеграцией API и для небольших фрагментов озвучки. Поле синтеза принимает до 5000 символов. Для доступа к AI Studio выбирается каталог, где у аккаунта есть роли ai.playground.user и ai.datasets.editor или более высокие; для начала работы со SpeechKit также нужен активный платёжный аккаунт Yandex Cloud. Если требуется автоматически собирать множество реплик, сервис доступен через API, а ручной интерфейс удобно оставить для контроля спорных фрагментов.
Как синтезировать тестовый фрагмент
- Откройте Yandex AI Studio. Выберите каталог, для которого у аккаунта есть необходимые роли доступа, затем на левой панели раскройте AI Speech и выберите «Синтез речи».
- Вставьте короткий проверочный отрывок. Для первого прохода достаточно 2–4 предложений с теми элементами, которые могут вызвать ошибку: имя, дата, число, иностранное слово, профессиональный термин.
- Настройте произношение. В левой части интерфейса доступны средства для пауз, акцента, ударения и фонетических подсказок. Не размечайте весь текст заранее: сначала устраните только реально слышимые ошибки.
- Выберите параметры голоса. Справа задаются язык, голос, роль, скорость речи, высота тона и формат аудио. Диапазон скорости в Playground — от 0,1 до 3,0. Для обычной дикторской озвучки лучше начать с нейтрального значения и менять его после прослушивания.
- Нажмите «Синтезировать и воспроизвести». Сразу прослушайте результат на тех словах, ради которых создавался тест. При ошибке вернитесь к тексту или разметке, а не пытайтесь компенсировать произношение постобработкой.
- Скачайте удачный результат. После синтеза дорожку можно сохранить и использовать в монтаже. Для длинного материала повторите тот же процесс по логическим сценам, сохраняя единые настройки голоса.
Что проверить перед массовой генерацией. Сделайте отдельный эталонный блок с характерной скоростью, вопросом, перечислением, именем и числом. Если голос устраивает на таком материале, зафиксируйте выбранные параметры. Изменение голоса или роли в середине проекта без сюжетной причины заметно сильнее, чем небольшая разница громкости, которую можно выровнять на монтаже.
Типичная ошибка. Отправлять на синтез экранный текст со служебными подписями, скобками и длинными URL. Удалите всё, что зритель должен видеть, но не слышать. Если адрес необходимо произнести, перепишите его в форму, понятную на слух.
3. SaluteSpeech App: вариант для уже подключённых проектов
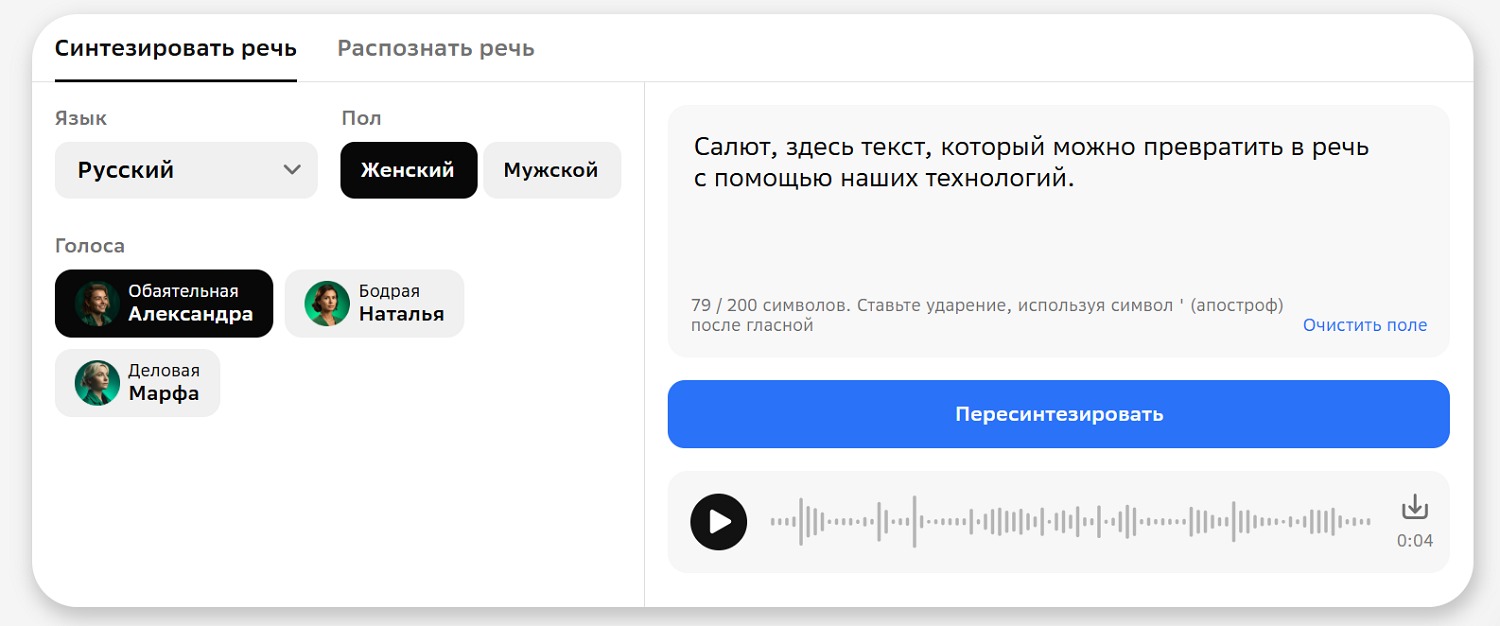
SaluteSpeech включает распознавание и синтез речи и имеет настольное приложение для Windows и macOS. Однако для выбора этого способа важен текущий статус: с 15 июля 2026 года подключение новых клиентов к SaluteSpeech недоступно. Продолжать работу могут проекты, у которых уже есть действующий пакет и доступ. Поэтому этот маршрут имеет смысл прежде всего для существующей инфраструктуры, а не как способ начать новый проект в 2026 году.
В настольном приложении для синтеза используется вкладка «Синтез». Пользователь выбирает голос, вводит текст и может добавлять управляющую разметку: ударения, акцент, паузы, дополнительный голос, интонацию и управление эмоциями. После обработки результат появляется в истории синтезов и доступен для загрузки в WAV.
Как получить реплику в существующем проекте
- Авторизуйтесь в приложении данными действующего проекта. Для работы требуется ранее созданный проект и действующая авторизация.
- Перейдите на вкладку «Синтез». Выберите голос. При необходимости интерфейс позволяет задействовать дополнительный голос для разметки отдельных частей текста.
- Введите подготовленный текст. Сначала используйте обычную пунктуацию. Затем добавляйте управляющие элементы только там, где слышен конкретный недостаток.
- Расставьте управляющую разметку. На панели доступны «Ударение», «Акцент», «Пауза», «Доп. голос», «Интонация» и «Управление эмоциями».
- Нажмите «Синтезировать». После обработки откройте «История синтезов», прослушайте дорожку и скачайте WAV для дальнейшего монтажа.
Что проверять. При повторной генерации фразы сравнивайте не только тембр, но и длину пауз. Если новая версия должна заменить старую в уже смонтированном ролике, изменение длительности способно сдвинуть синхронизацию с титрами и графикой. В таком случае лучше пересобрать реплику целиком, а не вклеивать одно слово посреди слога или шумового хвоста.
Ограничение способа. Для нового пользователя этот маршрут сейчас закрыт из-за прекращения новых подключений. Не стоит строить новый производственный процесс вокруг сервиса, к которому нельзя подключить свежий проект.
4. Android: системный синтез речи для чтения текста на устройстве
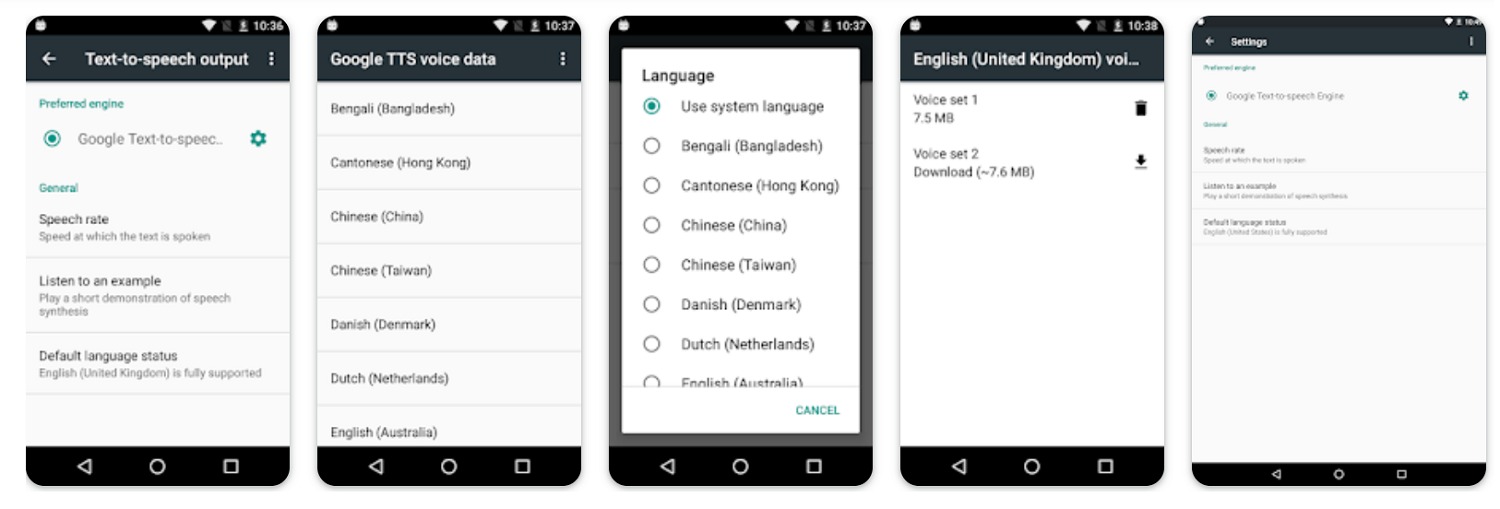
Android содержит системные настройки text-to-speech, которые используют функции доступности и приложения, умеющие обращаться к TTS. Такой способ отличается от облачного генератора дорожек: его основная задача — озвучивать текст на устройстве, а не готовить мастер-файл для видеомонтажа. Зато он полезен для проверки интерфейсных фраз, навигации и доступности контента.
В Android параметры находятся по пути «Настройки» → «Специальные возможности» → «Синтез речи» или «Преобразование текста в речь» — название пункта зависит от оболочки и локализации. Там выбираются предпочитаемый движок, язык, скорость и высота тона. Доступность конкретных движков зависит от устройства: это может быть системное решение Google, производителя смартфона или установленный сторонний компонент.
Как проверить TTS на смартфоне
- Откройте «Настройки» и раздел специальных возможностей.
- Перейдите к параметрам синтеза речи.
- Выберите предпочитаемый движок и язык.
- Установите скорость и высоту тона. Начните со стандартных значений, чтобы оценить произношение без дополнительного ускорения.
- Запустите демонстрационное воспроизведение и проверьте, легко ли понять фразу на обычной громкости смартфона.
- Для другого языка откройте установку голосовых данных, если этот пункт доступен для выбранного движка.
Когда этот способ уместен. Он полезен разработчикам интерфейсов, авторам инструкций и тем, кто проверяет доступность текста на реальном устройстве. Для производства аудиодорожки ролика лучше использовать сервис, который явно сохраняет синтез в файл и позволяет контролировать формат экспорта.
Как проверить качество синтезированной речи
Оценивать TTS только по приятности тембра недостаточно. Голос может звучать убедительно, но путать ударение в названии объектива или произносить диапазон чисел так, что слушатель понимает другой смысл. Контроль лучше проводить в фиксированном порядке: содержание, произношение, просодия, техническое состояние файла и сочетаемость с видеорядом.
Сначала проверьте содержание
Прослушайте дорожку одновременно со сценарием. Отмечайте пропуски, повторы, неверно прочитанные числа, окончания, сокращения и имена. Такая проверка особенно важна после нескольких итераций текста: легко заменить абзац в документе, но оставить в монтажной папке старую аудиоверсию.
Для проекта из десятков реплик полезна простая таблица: номер сцены, имя файла, версия текста, статус проверки. Это снижает риск случайно поставить в ролик черновой синтез, который по тембру почти не отличается от финального.
Затем слушайте ударения и связность
Ошибочное ударение обычно слышно сразу, а неудачная связность — на границе слов и предложений. Обращайте внимание на слишком короткие служебные слова, растянутые гласные, внезапно проглоченные окончания и резкую смену интонации посреди одной мысли. Если дефект повторяется на конкретном слове, корректируйте произношение. Если он появляется на границе длинной фразы, измените пунктуацию или разбейте предложение.
Проверьте паузы относительно изображения
Для видео важна не только речь сама по себе, но и момент, когда она звучит. Пауза должна оставлять время на прочтение подписи, просмотр действия курсора или смену плана. Если реплика постоянно догоняет картинку, сначала переработайте текст. Простое ускорение до неестественного темпа ухудшает восприятие и делает обучающий ролик сложнее.
На финальном монтаже удобно свести голос с изображением и музыкой в одном проекте; принципы такого процесса можно посмотреть в материале о монтаже, цвете и работе со звуком. Для длинных разговорных материалов также полезен подход, где монтаж строится вокруг текста и расшифровки — он разобран в статье про монтаж видео и подкастов через расшифровку.
Отдельно оцените технический файл
Даже правильно синтезированная реплика может быть испорчена после экспорта. Проверьте отсутствие перегрузки, обрезанных концов слов, щелчков на монтажных стыках и резкого изменения уровня между соседними сценами. Если файл будет повторно кодироваться в видеоредакторе, не стоит заранее несколько раз перегонять его между сжатыми форматами без необходимости.
Храните исходный синтез и обработанный мастер раздельно. Тогда можно определить, где возник дефект: в TTS, в аудиоредакторе или после финального кодирования видео. Такая структура проекта важнее сложной обработки, потому что делает ошибку воспроизводимой и позволяет откатиться на предыдущий этап.
Типичные артефакты: причина и безопасное исправление
| Что слышно | Где искать причину | Что сделать |
|---|---|---|
| Неверное ударение | Текст и разметка произношения | Указать ударение средствами TTS или переформулировать фразу |
| Число читается не в том значении | Нормализация текста | Записать число словами в нужном падеже |
| Слишком длинная или короткая пауза | Пунктуация и просодическая разметка | Изменить знак препинания либо задать явную паузу |
| Фраза монотонна | Структура предложения и настройки голоса | Разбить длинную конструкцию, уточнить логические акценты, затем проверить роль и темп |
| Стык щёлкает после монтажа | Аудиоредактор | Перенести точку реза в тишину или сделать короткий плавный переход |
| Голос перегружен | Усиление после синтеза | Вернуться к исходному файлу и уменьшить подъём уровня |
| Одно слово заметно отличается по тембру | Локальная пересборка реплики | Пересинтезировать фразу целиком с теми же настройками |
| Иностранное имя читается по правилам русского языка | Произношение | Использовать фонетическую подсказку или вариант написания, который даёт требуемое звучание |
Неверное ударение
Это одна из самых заметных ошибок в русской озвучке. Не нужно менять скорость всего голоса ради одного слова. Исправляйте конкретное слово средствами сервиса, затем генерируйте предложение заново и сравнивайте с предыдущей версией. Если слово повторяется много раз, сначала добейтесь стабильного произношения на коротком тесте.
Странное чтение цифр, дат и сокращений
Причина чаще находится в тексте, а не в акустической модели. Система должна определить, что означает запись, и выбрать грамматическую форму. Перепишите неоднозначный фрагмент словами. Для технического контента это особенно важно: «24–70» в названии объектива, «4K», «50p» и «1/50» несут разные типы информации и не должны автоматически произноситься по одному правилу.
Слишком ровная интонация
Монотонность часто появляется, когда сценарий состоит из длинных канцелярских конструкций. Разбейте предложение, вынесите главное действие ближе к началу и поставьте смысловую паузу. После текстовой правки уже имеет смысл пробовать роль или интонационные настройки TTS. Если менять только высоту тона или скорость, плохо построенная фраза останется трудной для восприятия.
Резкий стык после замены одного слова
Синтезированная речь зависит от контекста: одно и то же слово внутри разных предложений получает разные длительности и интонацию. Поэтому отдельное слово, вклеенное из новой генерации, может не совпасть по ритму и тембру с соседними. Надёжнее пересинтезировать всё предложение либо логически завершённую реплику.
Щелчок после ручной обрезки
Щелчок возникает уже не из-за TTS, а из-за разрыва звуковой волны в неудачной точке. Режьте по тишине или используйте короткое плавное затухание и нарастание. После правки прослушайте стык в наушниках и на обычных динамиках: тихий дефект иногда не заметен на одной системе и хорошо слышен на другой.
Сценарии использования синтеза речи
Озвучка видео и скринкастов
Для видеоролика TTS удобен тем, что текст можно менять после монтажа без повторной студийной записи. Но производственный процесс лучше строить по сценам. Сначала фиксируется текст конкретного кадра, затем генерируется реплика, после чего её длительность сверяется с изображением. Если фраза не помещается, правится сценарий или визуальный тайминг, а не только скорость воспроизведения.
Храните голос отдельно от фоновой музыки и эффектов. Это позволяет пересобрать баланс без повторного синтеза. Если проект будет локализоваться, отдельные дорожки особенно полезны: видео и эффекты остаются прежними, меняется только речевой слой.
Обучающие материалы и инструкции
Здесь важнее всего точность терминов и возможность повторять одинаковые названия элементов интерфейса. Перед массовой генерацией соберите список слов, которые система произносит нестабильно: названия программ, форматов, команд, кнопок и английских терминов. Сделайте короткую контрольную дорожку и только после её проверки синтезируйте основные главы.
Темп инструкции должен оставлять время на выполнение действия. Если голос говорит «нажмите кнопку и выберите параметр» быстрее, чем зритель успевает найти элемент, проблема не в том, что TTS недостаточно медленный. Часто полезнее сделать паузу между действием и результатом или разбить одну реплику на две.
Подкасты и длинная повествовательная речь
На длинной дистанции слышны дефекты, которые незаметны в коротком рекламном ролике: повторяющаяся мелодика предложений, одинаковая пауза перед каждым абзацем, слишком ровный темп. Поэтому главу лучше проверять не только фрагментами, но и непрерывным прослушиванием нескольких минут. Если утомляет ритм, редактируйте структуру текста и длину предложений.
Для серийного проекта зафиксируйте голос, темп и правила произношения до первой публикации. Замена настроек между выпусками создаёт ощущение другого диктора, даже когда имя голоса в сервисе осталось тем же.
Доступность интерфейсов
Системный TTS помогает проверить, как текст воспринимается без визуальной опоры. Кнопки, статусы и короткие инструкции должны быть понятны сами по себе. Разработчику важно не только услышать фразу, но и убедиться, что порядок элементов в интерфейсе соответствует логике чтения экранными средствами доступности.
Автоматические уведомления и голосовые интерфейсы
В динамических сценариях текст собирается из переменных: имени, времени, статуса заказа, адреса или результата операции. Здесь заранее проверяют не одну фразу, а набор грамматических сочетаний. Число и существительное должны согласовываться, а пустое значение не должно приводить к бессмысленной паузе или чтению технического маркера.
Для таких систем ручной Playground удобен как стенд проверки, а производство обычно переносится в API. Важно сохранять тестовый набор фраз после каждой правки шаблона: он помогает быстро заметить, что изменение одной переменной сломало произношение в другом случае.
Форматы и монтаж: как не испортить готовый голос
После TTS начинается обычная работа со звуком. Для промежуточного мастера удобнее сохранить версию без повторного лишнего сжатия, а публикационный файл делать уже после сведения. Это особенно важно, когда голос несколько раз проходит через TTS, аудиоредактор, видеоредактор и финальный кодировщик: каждое ненужное поколение сжатия усложняет контроль качества.
Частоту дискретизации и число каналов лучше привести к параметрам основного проекта один раз перед финальным сведением. Если проект собран с едиными параметрами, меньше скрытых преобразований происходит при импорте и рендере. Для одиночного дикторского голоса стерео само по себе не добавляет детализации: важнее отсутствие перегрузки, чистые монтажные стыки и правильный уровень относительно музыки.
Удобно разделить папку проекта на четыре уровня: исходный синтез, исправленные версии, мастер после обработки и финальный экспорт. Тогда аудиофайл с ошибочным ударением не перепутается с утверждённым, а после замечания заказчика можно вернуться к чистой версии без извлечения звука из уже сжатого видео.
Матрица сохранности результата
| Этап | Что сохранить | Что можно изменить без потери исходника | Что нельзя восстановить из финала точно |
|---|---|---|---|
| Подготовка текста | Утверждённый сценарий | Пунктуацию, произношение, деление на реплики | Историю правок, если остался только звук |
| Синтез | Чистые скачанные реплики | Повторную генерацию отдельных сцен | Исходные настройки, если они нигде не зафиксированы |
| Аудиообработка | Отдельный мастер и исходный TTS | Обрезку, уровень, умеренную коррекцию | Чистый сигнал после разрушительной перезаписи единственной копии |
| Видеомонтаж | Проект и связанные аудиофайлы | Тайминг, баланс, музыку и эффекты | Отдельную несжатую речь, если остался только финальный ролик |
Эта схема особенно полезна для длинных проектов. Исправление одного термина в третьей главе не должно требовать повторной генерации всей озвучки. Чем меньше этапы зависят друг от друга, тем проще заменить конкретную реплику и проверить, что остальные части не изменились.
Что важно знать о голосовом клонировании, правах и доверии аудитории
Обычный TTS с готовым голосом и клонирование конкретного человека — разные уровни риска. Когда система воспроизводит узнаваемые особенности реального человека, появляются вопросы согласия, прав на запись и допустимого контекста использования. Наличие технической функции не означает автоматического разрешения на использование чужого голоса в публикации, рекламе или коммерческом продукте.
Рабочий принцип — использовать собственный голос, голос, предоставленный сервисом на его действующих условиях, либо материал, на использование которого получено необходимое согласие. Перед публикацией также важно сверить условия лицензирования выбранного TTS с реальным сценарием: личным роликом, клиентской работой, рекламой, приложением или массовой генерацией.
Синтетический голос не должен создавать ложное впечатление, что конкретный человек произнёс слова, которых он не говорил. Для реконструкций, демонстраций и имитаций уместно ясно обозначать искусственное происхождение речи, когда без такого пояснения аудитория способна неверно понять происхождение записи.
Для рабочих материалов сохраняйте исходный текст, дату генерации, название используемого голоса и версию аудио. Это не заменяет юридические документы, но помогает точно установить, какой текст был озвучен и какой файл попал в публикацию.
Как выбрать подходящий маршрут
| Задача | Подход | Что проверить первым |
|---|---|---|
| Нужна отдельная озвучка для ролика без программирования | SpeechKit в AI Studio, затем при необходимости АудиоМАСТЕР | Произношение имён, длительность фраз, формат сохранения |
| Голос уже синтезирован, но требуется подготовить его к монтажу | АудиоМАСТЕР | Обрезку краёв, уровень, стыки и экспорт |
| Есть действующий проект SaluteSpeech | SaluteSpeech App | Статус доступа, голос, разметку и историю синтезов |
| Нужно проверить чтение текста на смартфоне | Системный TTS Android | Движок, язык, скорость и высоту тона |
| Нужна автоматическая генерация множества реплик | API выбранного TTS после ручной проверки эталонного текста | Стабильность разметки, обработку ошибок и единые параметры проекта |
Для автора видео наиболее предсказуемая схема — разделить генерацию и постобработку. Сначала добиться правильного произношения в TTS, затем сохранить чистый файл и только после этого монтировать, выравнивать уровень и сводить с музыкой. Если этапы смешать, легко потратить время на обработку реплики, которую всё равно придётся пересинтезировать из-за одного неверного ударения.
Чек-лист перед финальным экспортом
- Сверьте текст и звук. В финальной дорожке должна звучать последняя утверждённая версия сценария.
- Прослушайте имена и числа. Эти элементы чаще всего несут фактическую ошибку, которую зритель не сможет восстановить по контексту.
- Проверьте начало и конец каждого файла. Согласные не должны обрезаться, а тишина не должна быть непропорционально длинной.
- Сравните громкость соседних сцен. Зрителю не следует постоянно менять громкость из-за разных партий синтеза.
- Прослушайте голос с музыкой. Частотная коррекция и уровень оцениваются в миксе, а не только в сольном режиме.
- Проверьте паузы по видео. Зритель должен успевать увидеть то, о чём говорит голос.
- Сохраните исходный синтез. Оригинал нужен для отката и повторной обработки без накопления потерь.
- Храните мастер отдельно от публикационного файла. Финальный сжатый звук или дорожка внутри видео не должны быть единственной копией проекта.
- Проверьте файл после рендера. Ошибка может появиться при финальном кодировании, даже если мастер звучал правильно.
- Сделайте контрольное прослушивание на другом устройстве. Телефон, ноутбук и наушники по-разному выявляют резкость, тихие щелчки и недостаток разборчивости.
Вопросы, которые возникают при первой работе с TTS
Можно ли сделать хороший синтез без специальной разметки?
Для простого текста — да: современные системы работают с обычной пунктуацией и контекстом. Разметка нужна там, где результат не совпадает с требуемым произношением или таймингом. Сначала отредактируйте сам текст, затем добавьте ударение, паузу или фонетическую подсказку только в проблемных местах.
Почему короткая тестовая фраза звучит хорошо, а длинный абзац — монотонно?
В длинном абзаце повторяются однотипные синтаксические конструкции, а логические границы выражены слабее. Разбейте текст на смысловые предложения, сократите вложенные обороты, добавьте естественные переходы и заново прослушайте несколько минут непрерывной речи. Оценка по одной эффектной фразе не показывает, насколько голос подходит для длинного материала.
Нужно ли обрабатывать TTS после генерации?
Не всегда. Если дорожка уже подходит по уровню и используется без сложного сведения, дополнительная обработка только увеличит число операций. Для видео с музыкой, несколькими дикторами или готовыми вставками обычно приходится хотя бы обрезать края, выровнять относительный уровень и проверить стыки. Содержательные ошибки исправляются повторным синтезом, а не фильтрами.
Почему нельзя просто ускорить слишком длинную реплику?
Сильное ускорение ухудшает разборчивость и меняет естественный ритм. Сначала сократите текст, уберите повтор и разбейте сложное предложение. Скорость синтеза лучше использовать как точную настройку, а не как замену редактуре сценария.
Что хранить после завершения проекта?
Минимальный набор — утверждённый текст, исходные синтезированные файлы, обработанный мастер и финальный медиапроект. Для серийной работы добавьте список выбранных голосовых параметров и правила произношения сложных названий. Тогда следующий выпуск можно собрать с тем же характером звучания, а старую реплику — восстановить без копирования из сжатого видео.
Можно ли использовать один голос для всех типов контента?
Технически один голос можно применять в разных проектах, но требования к подаче меняются. Для интерфейсного уведомления важны краткость и разборчивость, для длинной лекции — устойчивый ритм, для ролика — совместимость с музыкой и таймингом сцены. Поэтому голос и темп стоит оценивать на реальном типе текста, а не только на демонстрационной фразе.
Итог
Синтез речи — не одна кнопка, а цепочка от нормализации текста до проверки готового звука. Качественный результат начинается со сценария: однозначных чисел, проверенных имён, коротких смысловых фраз и понятных пауз. TTS отвечает за произношение и голос, а аудиоредактор — за монтажные края, уровень и техническую подготовку файла.
Для первого теста достаточно взять короткий фрагмент с числом, именем и сложным термином, синтезировать его в SpeechKit, исправить произношение и сохранить результат. Затем обработайте копию в АудиоМАСТЕР, когда дорожке нужны обрезка или выравнивание. После этого проверьте голос уже внутри видео или интерфейса: именно там становятся заметны лишние паузы, слишком длинные фразы и проблемы с балансом. Такой порядок позволяет исправлять ошибку на том этапе, где она возникла, а не маскировать её следующей обработкой.